联通广东产互 × OceanBase AI 存储底座实践:元数据延迟从 2.1s 降至 12ms
联通广东产互 COP 运营中心基于 JuiceFS 与 OceanBase 建设 AI 存储底座,覆盖 Hive 冷数据归档与语音模型训练,元数据操作延迟从平均 2.1s 降至 12ms。本文介绍选型验证、场景实践与落地经验。
编者按
数智化业务高速增长下,两类存储难题常困扰着拥有高并发、高实时要求的数据团队:
一是 Hive 数仓每年数据量高速增长,集群存储濒临打满,无新增服务器扩容就会阻断新数据写入;将冷数据切换至 OSS 虽能释放空间,但对象存储缺少目录元数据,文件越多,列表遍历、分区查询耗时越长,简单 ls 命令都要久等,陷入 “存得起、查不动” 的困境。
二是语音 AI 训练采用 NAS 或本地磁盘,海量小文件压垮单机元数据能力,频繁 Checkpoint 写入造成 IO 阻塞、训练任务中断,跨机房训练还因元数据不一致,导致实验结果不可复现。
搭建兼顾冷存储降本、海量小文件元数据高性能、跨地域强一致的 AI 数据湖底座,看似只是组件组合,落地中亿级元数据延迟、运营商级容灾、存量迁移、组件兼容等问题,都直接决定成败。
联通广东产互 COP 运营中心基于 JuiceFS+OceanBase 落地 AI 存储底座,兼顾 Hive 冷查询提速、语音训练迭代加速与高可靠容灾。本文分享业务背景、选型验证、场景实践与可复用经验。
全文 3501 字,阅读约需 7 分钟。本文作者方主升,来自联通(广东)产业互联网有限公司 COP 运营中心数据平台团队。
作为联通广东产互的数据平台团队,承担着 AI 数据湖建设、语音模型训练数据管理、Hive 冷数据归档等核心数据基础设施职能。
随着数智化转型推进,AI 训练数据与小文件规模快速增长,传统 HDFS + NAS 架构在元数据扩展性、跨地域一致性及运维成本方面逐渐难以满足业务需求。
当前业务核心痛点如下:
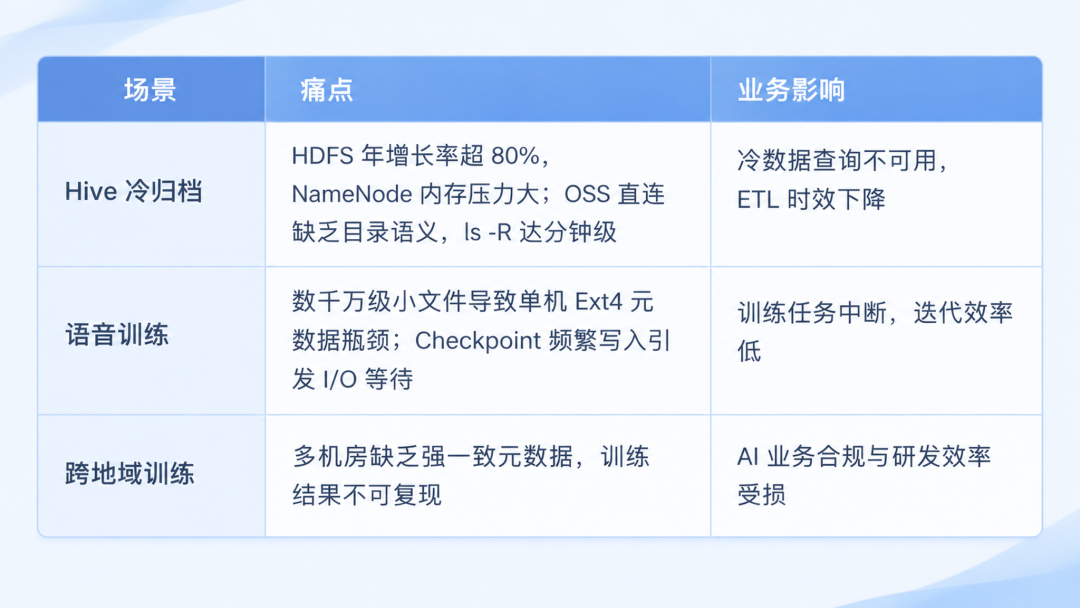
上述痛点的共同根源是:JuiceFS 的性能高度依赖元数据引擎。我们需要一款兼具强一致性、高并发、易扩展、符合运营商级容灾要求、且能与现有 MySQL 生态衔接的元数据存储方案。
COP团队调研了 Redis、MySQL(主从)、 OceanBase 等元数据引擎方案,在相同测试环境, 针对 JuiceFS 典型元数据操作(create / stat / rename / list / delete)进行压测与容灾验证,最终选择了 OceanBase。
对比情况如下:
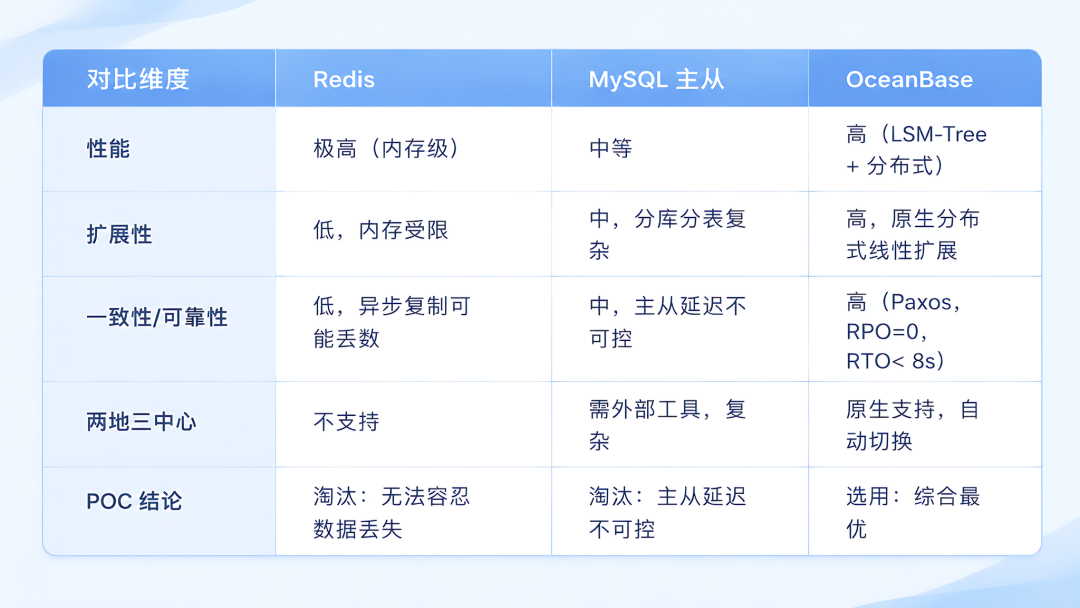
选择 OceanBase 的核心理由
强一致 + 高并发:LSM-Tree 引擎支撑2万+ TPS 元数据混合负载,满足训练与归档双场景
运营商级容灾:三副本 Paxos 部署,同城双活 + 异地灾备,RPO=0,RTO<8s;元数据定期备份至 OSS
MySQL 生态兼容:JuiceFS 元数据引擎可直接使用 MySQL 协议接入,降低升级与运维门槛
线性扩展:亿级元数据无单点内存瓶颈,支撑业务持续增长
改造前后结构对比如下:
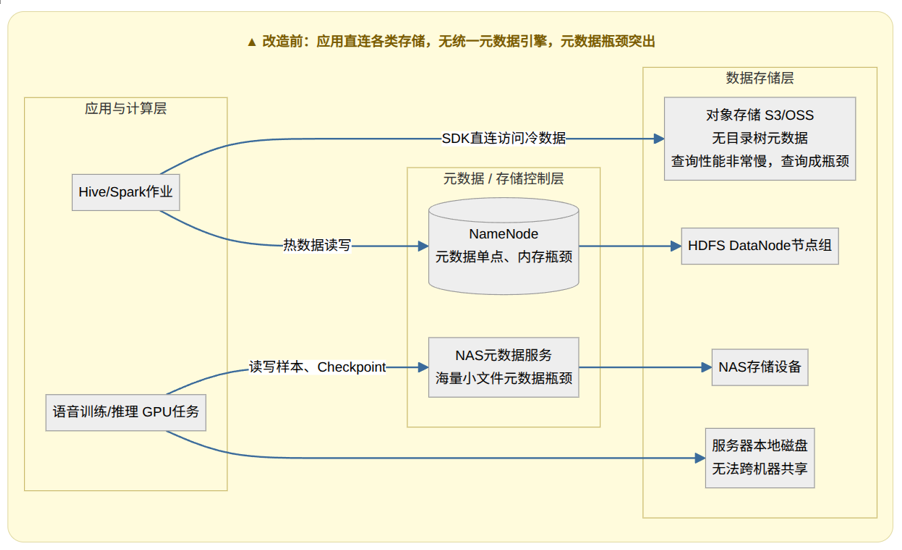
原有存储体系(HDFS + 直连 OSS + NAS + 本地盘)
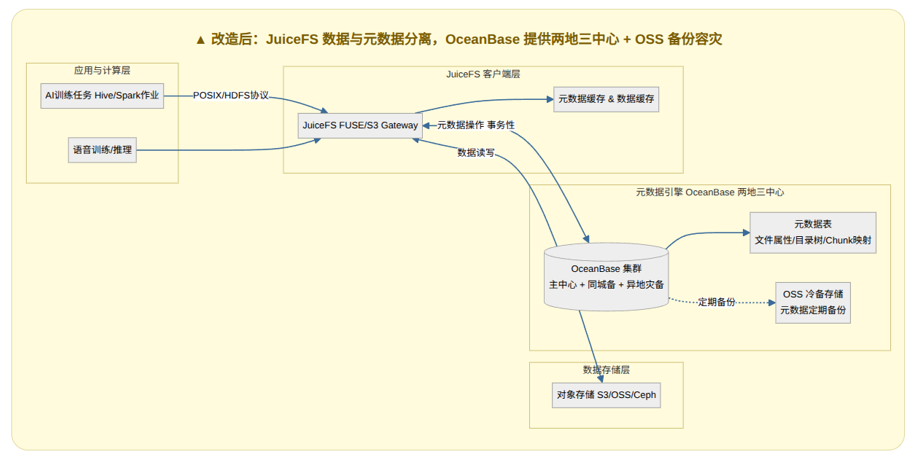
元数据层:OceanBase 存储文件属性、目录树、chunk 映射,JuiceFS 客户端通过事务性 SQL 操作元数据
数据层:对象存储(OSS)承载实际文件内容,冷数据归档后大幅降低成本
接入层:OBProxy 负载均衡,JuiceFS 多客户端并发访问
容灾层:OceanBase 三副本跨 AZ/跨地域部署 + OSS 定期冷备,主备一键切换
在该场景中,JuiceFS 作为统一的文件系统层,将 Hive 冷数据从 HDFS 切换至对象存储,而 OceanBase 则承载其全部元数据,彻底解决了传统架构的瓶颈。
原有痛点(HDFS + 对象存储)
数据量高速增长,HDFS 存储空间紧张:历史数据年增长率超 80%,HDFS 集群扩容成本极高,且 NameNode 内存压力巨大。
冷数据归档到 OSS 后查询速度极慢:对象存储缺乏目录树语义,ls -R、grep 等操作需遍历全部对象,延迟高达分钟级,业务无法接受。
JuiceFS(1.2.4)+ OceanBase(4.3.5) 解决方案
JuiceFS 元数据外置:所有文件属性、目录树、chunk 映射均存储在 OceanBase 中,JuiceFS 客户端通过事务性 SQL 操作元数据,ls / rename 毫秒级响应。
OceanBase 线性扩展:支撑亿级元数据,彻底消除单点内存瓶颈,无扩展上限。
强一致性事务:OceanBase 为 JuiceFS 元数据操作提供 ACID 事务支持,保障相关元数据更新的原子性与一致性,降低并发操作和异常中断造成元数据不一致的风险,为文件访问提供可靠支撑。
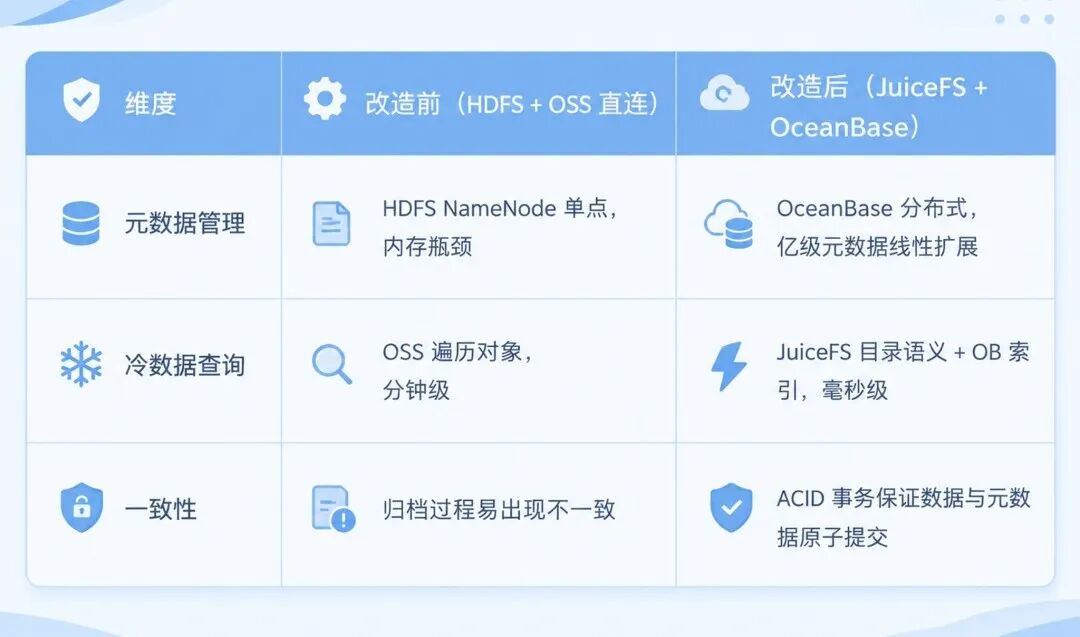
将 Hive 冷数据从 HDFS 切换至 JuiceFS(数据层 OSS、元数据层 OceanBase),改造前后对比如下:
性能提升量化
冷数据查询性能提升 200%: 借助 JuiceFS 的元数据缓存与 OceanBase 的高性能查询,典型 ETL 作业(如分区扫描)性能提升 200%。
相比 HDFS 仅下降 20%:归档到 JuiceFS 的冷数据查询性能只比原生 HDFS 下降 20%,远超 OSS 原生性能。
存储成本降低 70%: 冷数据切换至 OSS 后,存储成本大幅下降,同时查询性能仍保持在可接受范围。
归档任务性能提升 300%,元数据操作延迟从平均 2.1s 降至 12ms,查询性能提升 200%,运维人力下降 60%,HDFS 集群稳定运行超 1 年无 Full GC 异常。
在语音模型训练中,JuiceFS 为海量小文件和大模型 Checkpoint 提供了统一命名空间,而 OceanBase 则保障了高并发下的元数据极致性能。
原有痛点(传统 NAS / 本地盘)
海量小文件元数据爆炸: 语音切片达数千万级,单机元数据服务(如本地 Ext4)无法支撑,stat 操作延迟飙升。
Checkpoint 写入抖动: 大模型 Checkpoint 频繁写入,元数据提交成为瓶颈,训练任务因 I/O 等待而中断。
跨地域训练数据不一致: 多机房训练任务共享数据,缺乏强一致元数据同步,导致训练结果不可复现。
JuiceFS + OceanBase 如何解决
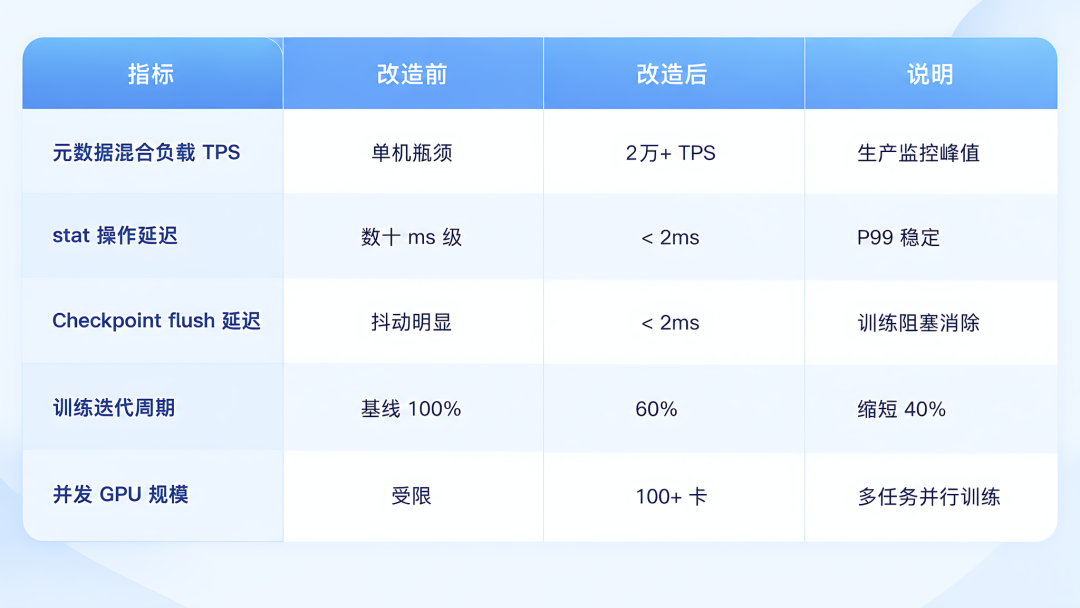
JuiceFS 元数据高性能:利用 OceanBase 的 LSM-Tree 与分布式事务,JuiceFS 支撑了 2 万+ TPS 的元数据混合负载,stat 延迟稳定在 < 2ms。
Checkpoint 原子提交: JuiceFS 通过 OceanBase 快速提交 Checkpoint 元数据,flush 延迟 < 2ms,训练迭代周期缩短 40%。
全局强一致性: OceanBase 跨 AZ 的 Paxos 同步,JuiceFS 客户端在任意服务器均可读到最新数据,保障训练可重复性。
语音模型训练迭代周期缩短 40%,并支持了 100+ 并发 GPU 卡的训练任务
效果数据对比如下
存量文件切换、完整性校验、切换与回退方案
本次项目基于 JuiceFS 原生 sync 工具完成全量存量文件切换工作。该工具支持多线程并发传输、二进制级精准数据校验,且内置断点续传机制,能够显著提升文件切换效率,保障过程稳定可靠。
本次切换严格执行“先校验、后切换”的标准化流程,待源端与目标端数据校验完全一致、确认无误后,再开展源数据清理及业务流量切换操作。该机制保障异常场景下的快速回退,实现全流程可管控、可追溯,全方位规避数据切换风险。
落地兼容性问题及解决方案
JuiceFS 官方版本暂未完成对 OceanBase 数据库的全量适配,本项目初期采用 JuiceFS 的 MySQL 兼容模式完成业务对接。
在实际运行过程中,系统频繁出现事务异常,OceanBase 事务执行失败时会返回 unknown 未知状态字段。在 OceanBase 社区的协助下对日志进行分析,报错 4012 (25000) Transaction result is unknown 的根因为:事务提交指令已发起,但受提交异常、网络波动、节点故障、进程暂停等因素影响,客户端无法判定事务最终提交或回滚状态,该场景下客户端的标准处理方式为请求重试。
而 JuiceFS 原生代码无法识别该 unknown 状态关键字,未配置对应重试逻辑,最终导致文件读写流程异常、JuiceFS 读写失败,直接影响业务正常运行。
Juicefs 具体报错日志如下:
1 | 2026/06/1714:54:36.856678 juicefs[28170] <ERROR>: error: Error 4012 (25000): Transaction result is unknown |
最终解决方案:
OceanBase 环境优化修复:在 OceanBase 社区的协助下分析 OceanBase 的运行日志,定位 unknown事务异常的核心原因为测试环境采用机械硬盘,磁盘性能不足导致日志写入 clog 盘长时间挂起。通过将存储介质更换为 SSD 固态硬盘后,该报错问题彻底解决。
Juicefs 代码兼容适配:为规避同类兼容性问题、提升系统通用性,我们向 JuiceFS 社区反馈该缺陷,通过修改 JuiceFS 源码,新增对 OceanBase unknown 事务状态的识别能力,配置对应异常场景的查询重试机制,实现 JuiceFS 与 OceanBase 的稳定兼容适配。
方案代价与适用条件
本整体方案改造成本低、资源开销小,无需额外占用大量缓存资源,对网络延迟、跨地域部署场景均无特殊依赖。
同时,方案无需搭建复杂运维体系,不增加日常运维复杂度,具备落地门槛低、通用性强、运维轻量化的显著优势,可完美适配本项目现有技术架构与线上运行环境。
该实践对两类业务具备极高借鉴价值:
一是 Hive 数仓集群存储告急、硬件扩容资源不足,需下沉冷数据到对象存储且不能牺牲查询性能;
二是 AI 语音训练存在千万级小文件,NAS / 本地磁盘元数据成为瓶颈,需要支撑大规模 GPU 并发训练,并要求跨机房元数据强一致、满足两地三中心容灾要求,均可参考本文的选型思路、切换方案及组件兼容排障经验。
通过将 OceanBase 作为 JuiceFS 的元数据引擎,COP运营中心成功构建了 **“**高性能、可扩展、金融级可靠” 的 AI 数据湖底座。
JuiceFS 借助 OceanBase 实现了冷数据存储成本降低约 70%,在 OSS 归档前提下保持可接受的查询性能,语音训练迭代周期缩短 40%,支撑 100+ 并发 GPU 卡,加速 AI 业务落地,并且跨地域训练数据强一致,保障实验可复现。
在技术创新层面,OceanBase 统一元数据引擎,消除 HDFS NameNode 单点与 NAS 元数据瓶颈,实现亿级文件元数据延迟从 2.1s 降至 12ms,混合负载达 2 万+ TPS,两地三中心 + OSS 冷备,RPO=0,RTO< 8s,满足 COP 运营中心核心业务要求。
在运维层面,整套解决方案使运维人力下降约 60%,HDFS 集群稳定运行超 1 年无 Full GC 异常,而且 OceanBase 和 MySQL 协议兼容,降低元数据引擎运维学习成本。
未来,COP 运营中心还将探索 OceanBase 的多租户能力与 JuiceFS 的表前缀(table_prefix)特性结合,实现更细粒度的元数据资源隔离,并进一步推进数据湖的智能缓存与预读策略优化。
最后感谢 OceanBase 社区的技术支持,期待更多同行在运营商场景中探索数据基础设施的创新组合。

OceanBase 社区版用户案例推荐
信也科技 OceanBase 实践:从风控核心到 AI 数据底座的探索
向量数据库多云部署方案与架构设计优化——作业帮AI业务的数据底座
浙江长龙航空HTAP实践:统一技术栈,高效构建在线服务与轻量实时数仓
科大讯飞三大场景应用OceanBase,亿级规模大表数据,查询性能快40倍
了解更多
添加社区小助手,加入微信交流群~
▼点击「阅读原文」,查看客户案例