从分布式数据库到 AI 湖库:OceanBase 的技术演进与思考
OceanBase 从分布式数据库向AI湖库演进,在一体化架构上统一管理结构化与多模态数据,结合数据处理、语义理解和Agent使用需求,探索非结构化数据的资产化路径。
编者按
OceanBase AI 湖库负责人竹翁,会在这篇文章里,为大家介绍 OceanBase 为什么要在一体化产品架构之上,衍生出一个全新的产品家族——AI 湖库,以及它如何让企业中占比 80%-90% 的非结构化数据,从“成本”变成“资产”。他表示,AI 让非结构化数据第一次可以被系统地处理、管理和理解。
正如结构化数据时代需要“湖仓一体”,多模态数据的管理也需要一个新的架构——湖库(Lakebase):用一套引擎统一管理结构化与多模态数据,并让数据具备可被 Agent 理解和使用的业务语义。
在完成一体化架构的变革之后,OceanBase 又一次在技术上做了全新的扩展。这一次扩展的幅度之大,甚至会让人产生疑问:这还算是在做数据库吗?本次分享要回答的,正是 OceanBase 如何从一个分布式数据库引擎,逐步演进为一个面向 AI 的全新产品家族的。
欢迎大家关注 OceanBase 社区公众号 “老纪的技术唠嗑局”。在这里,我们会持续为大家更新与 #AI 和 #Data 相关的技术内容~
先回顾 OceanBase 的技术发展历程。OceanBase 从 2010 年开始研发分布式数据库,最初可以认为是一个 NoSQL 数据库,后来逐渐演变为完整的关系型数据库,并不断增强对 MySQL、Oracle 的兼容性。从 3.x 开始,OceanBase 着手增强 TP 和 AP 混合负载的能力——因为在真正关键的核心业务系统里,其实很难严格区分哪些是 TP 场景、哪些是 AP 场景。
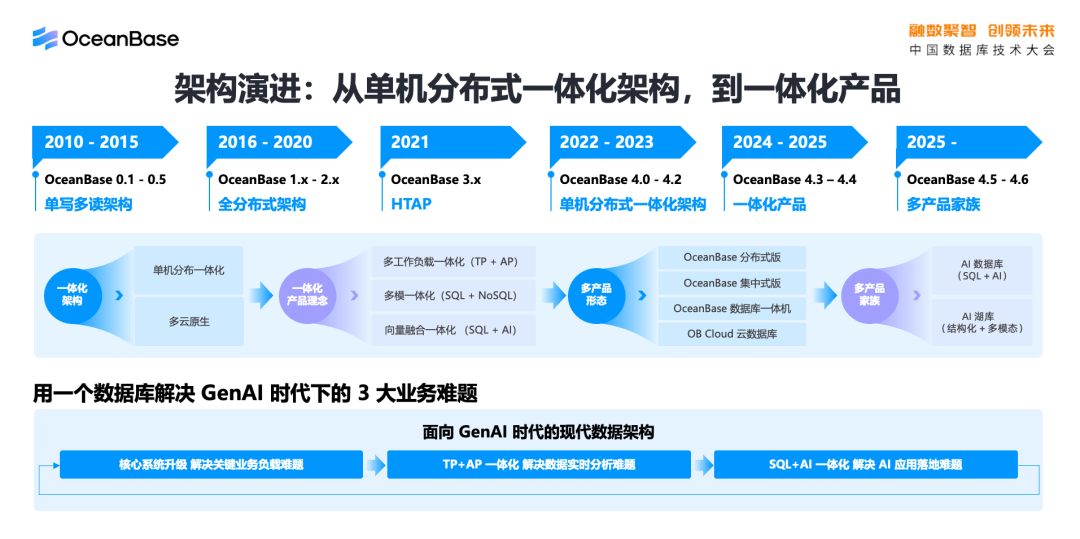
沿着这条路径继续演进,OceanBase 在分布式架构的基础上进一步增强了单机性能,在同一套代码体系中兼顾分布式技术与集中式技术,使得在单机分布式一体化架构下,单机性能能够达到与传统集中式数据库相当的效率,从而带来一体化的使用体验。
而这一次真正的变化在于:在 OceanBase 一体化产品架构之上,衍生出了一个全新的产品家族——AI 湖库。这件事情从 OceanBase 4.5 版本开始酝酿,如今正式对外呈现。这一变化背后的主要推动力,当然是 AI。
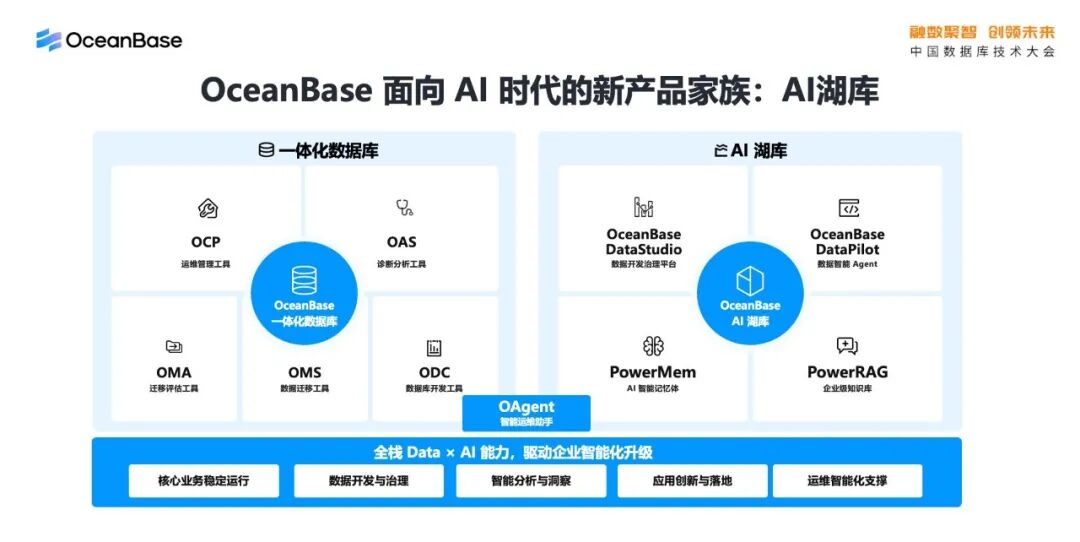
湖库的核心是一个存储与计算引擎,围绕这个引擎,OceanBase 构建了一套完整的生态体系加以配套:
- 包括专门用于数据开发治理的平台 OceanBase DataStudio;
- 面向数据开发与分析场景、以 Agent 方式提供服务的 OceanBase DataPilot;
- 专门用于 Agent 记忆管理的 AI 智能记忆体 OceanBase PowerMem;
- 以及专门用于文档知识库管理的企业级知识库组件 PowerRAG。
这些产品,都是围绕 OceanBase AI 湖库构建而成的。
接下来进入主题:OceanBase 为什么要做一个全新的产品——AI 湖库?
这里的关键问题是,OceanBase 所讲的 AI 湖库,与业界已有的相关概念到底有什么区别。过去很多数据库的演变,更多是在拼性能、拼成本这类话题。而 AI 时代给数据库领域的参与者带来了一个全新的机会,即重新审视数据库对于应用和业务的价值应该如何构建。
过去,中国的数据库企业更多是在国外厂商定义的标准之下,跟随其接口和产品方向;而如今,中国的 AI 发展走在了世界前沿,已经没有一个可以直接跟随的先行者,这也给数据库提出了一个全新的课题:作为存储与计算的基础设施,应当如何帮助应用和业务解决实际问题。
这个逻辑其实很简单:AI 使得非结构化数据可以被系统地处理、管理和理解,这是一个关键的观察。此前的机器学习浪潮已经让这件事初现可能,而这一轮大模型和生成式 AI 的爆发,则使它变得更贴近每一家企业的实际需求。
非结构化数据的管理,很多企业早已在做。过去的做法是搭建内容管理系统,把数据存下来,但存下来之后往往就被遗忘,只有其中一小部分能够被偶尔调用。因此,从企业数据资产的角度看,这些非结构化数据实际上是一种成本。真正值得思考的是,如何用 AI 技术把这部分成本,转化为像结构化数据一样的高价值资产。
从存储容量来看,企业中 80%-90% 的数据都是非结构化数据。这些数据如何变成可以被计算、被更好地管理和利用的资产?
OceanBase 给出的答案很简单:正如结构化数据时代需要“湖仓一体(Lakehouse)”这样的架构,非结构化、多模态数据的管理也需要一个全新的架构——AI 湖库(Lakebase)。
OceanBase AI 湖库这一产品家族,正是希望通过这样的全新架构,让结构化数据与非结构化数据能够被统一管理和治理。
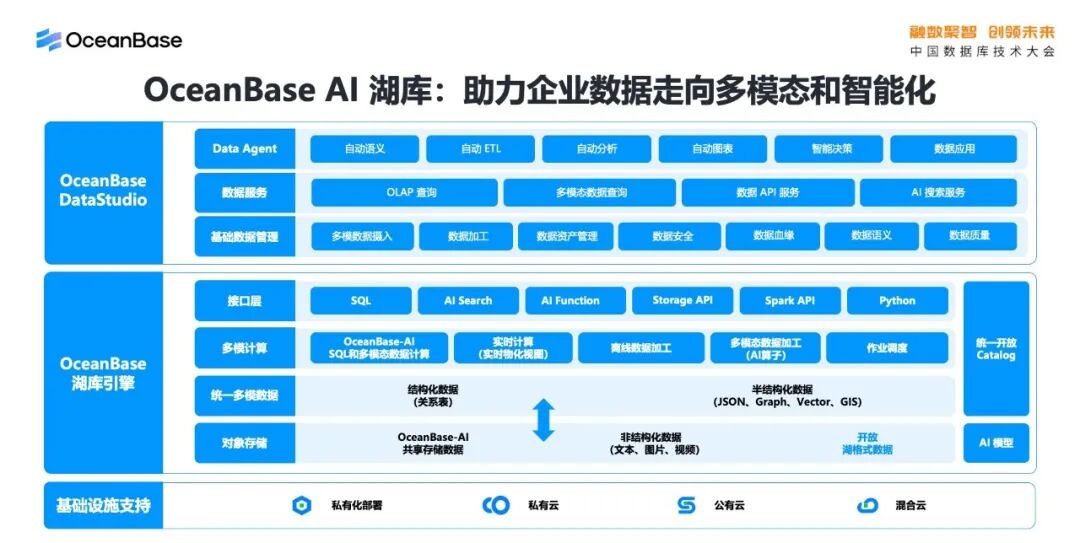
这套架构可以支持私有化部署,也可以在云上提供服务。
整个 OceanBase 湖库引擎可以分为几层:
- 最底层基于对象存储这类开放式存储架构,用于存储结构化、半结构化和非结构化数据;
- 第二层要把这些数据有效地组织起来,需要借助数据库技术构建索引,在多模态统一数据管理这一层,把结构化表、半结构化数据,以及一个要重点介绍的概念——多模表——统一融合在一起;
- 计算层以 OceanBase 的 SQL 引擎为核心进行扩展,支持多模态数据的管理、计算与处理能力,同时兼容 Spark、Ray 等开放计算引擎;
- 再上一层,从用户应用侧来看,主要以 SQL 为主,结合 Python 完成数据开发的闭环。
在这层引擎之上,为了实现 OceanBase 内外、库与库之间的数据融合,OceanBase 做了较大的改造,使内部的元数据可以被湖上的开放计算引擎无缝使用,反之,引擎内部也可以无缝访问湖上各种格式的开放式存储。
下面是处理层面几个比较关键的技术点。
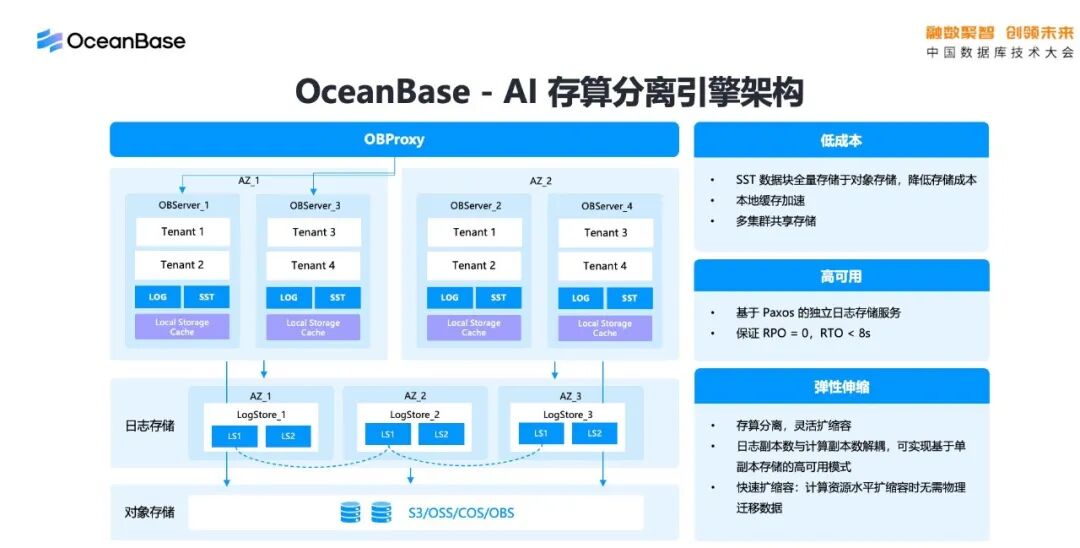
OceanBase 湖库最核心的部分,依然是依托多年积累的 OceanBase 引擎进行的重构与扩展。最核心的变化在于存储架构:由于需要与湖上数据充分融合,OceanBase 引擎的核心变为基于对象存储,作为所有数据最终存储和持久化的位置,同时配套日志服务完成事务的持久化。
在此基础上,系统依然保持分布式特性,通过存算分离实现存储和计算各自的弹性伸缩,支持多种模态数据的存储。
存算分离
第一个关键点是存算分离。
这一架构从 OceanBase 4.4 版本开始筹备,前年启动、去年完成首次发布,目前进一步演进为支持湖库融合的架构。其核心在于,存储不再需要像传统数据库那样保存多份副本,整个系统只需以对象存储为核心保存一份数据,并将对象存储视为一种可以随时获取的存储资源,在此基础上进行各种设计。同时,系统保留了此前积累的高可用能力,能够保证数据具备很短的 RTO。
有了存算分离之后,第一个容易获得的好处是:AI 时代很多数据的价值密度,一定低于以前账务系统中存储的数据。例如大量聊天记录被存入系统后,可能并没有很高的处理价值。因此,存算分离带来的第一个好处,就是可以让数据的冷热分层实现自动化。
在此基础上,OceanBase 进一步设计了策略控制能力,把数据分为三类:
- 标注为冷(COLD)的部分不会放入缓存,始终保留在对象存储上;
- 完全的热(HOT)数据会保留在本地化服务中;
- 中间状态(AUTO)的数据则由系统根据访问情况自动控制冷热淘汰。
无论是向量数据,还是像聊天记录这样的文本数据,都以这一能力为基础进行管理。
混合搜索
第二个核心能力是混合搜索。
Agent 对数据库提出的第一个改变,就是数据库需要具备良好的搜索能力——这一能力此前并非必须在数据库内部实现,但在新的应用场景下,首先要解决向量、文本、标量这三类数据类型的混合高效检索。
在这方面 OceanBase 持续增强:
- 从基础类型上,支持稠密向量和稀疏向量;
- 在索引结构上,自研了基于内存的向量索引,也自研了基于磁盘存储的高性价比索引,为客户提供综合选择。
- 在查询路径上,与传统数据库不同,需要以多路召回的方式同时检索向量和文本数据,并进行高效过滤——因为向量检索的计算成本相对更高,因此在查询优化目标上会尽量控制检索区域。
OceanBase 较早就支持了高性能的向量搜索,与一些专门做向量搜索的开源引擎相比,在多个维度上的性能表现都比较出色。
精简技术栈
以这些基础能力为核心,再来看湖库引擎架构相对于原有引擎的核心提升。
一般基于开源技术搭建的数据平台,如果自建,往往需要以复杂的引擎组合才能完成数据管理,而这还只是结构化数据管理部分。
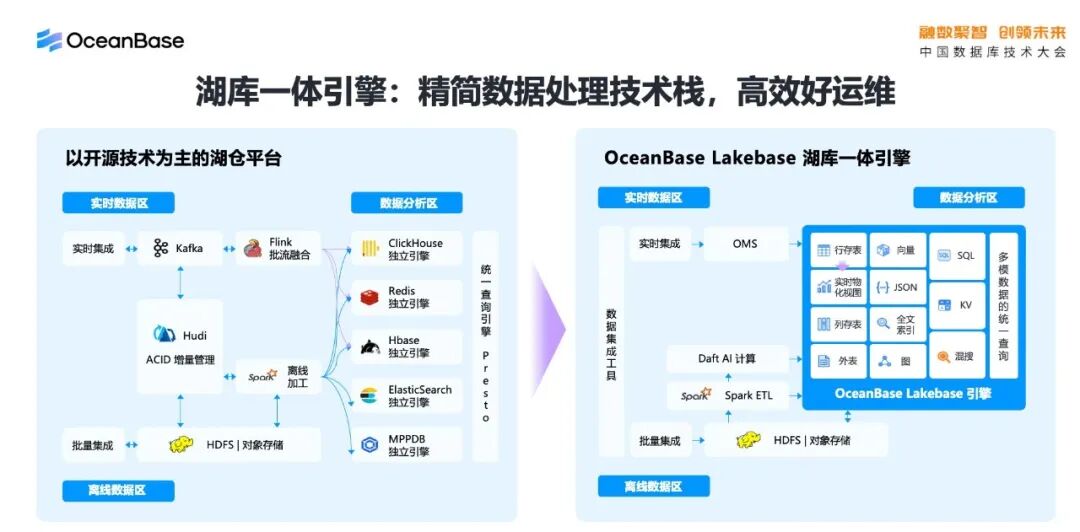
通常分为三部分:
- 第一部分是离线加工,采用 T+1 方式,引入 Hadoop 等大数据技术;
- 第二部分是实时系统,引入以 Flink 为代表的流式处理技术;
- 第三部分是数据服务层或数据分析层,面向 BI 应用或其他业务直接提供数据。
这就需要把湖上的数据导入各种引擎:
- 比如较早引入 ClickHouse 做实时分析,但它只能做单表查询、难以支持多表关联,又需要引入其他支持多表关联的数据库;
- 这些数据库通常点查性能不佳,因此又要引入 HBase 这类 NoSQL 系统做点查;
- 进入 AI 时代后,数据中又多了向量这一类型,还要引入向量数据库;
- 对于记忆存储和文本检索,则需要引入 Elasticsearch 等系统。
这样一来,就会在原有基础上不断“拼积木”式地引入新引擎——架构因此越来越复杂、越来越难以维护。
因此,第一个要解决的问题,是通过更简洁的架构,以 OceanBase 引擎为核心,用更精简的组件完成结构化数据与非结构化、多模态数据的加工处理。对于实时加工链路,核心技术是增量实时物化视图。
通过增量物化视图的方式,数据的实时处理无需引入数据库外部引擎,即可高效完成绝大多数复杂的加工与预处理。在这一架构下,整体计算量不会额外增加,管理员只需描述“加工要做什么”,而不需要描述“加工如何完成”——这就是通过增量物化技术实现分层加工的核心逻辑,可以避免维护复杂外部链路带来的问题。
多模表
接下来重点介绍一个关键的产品级技术——多模表。
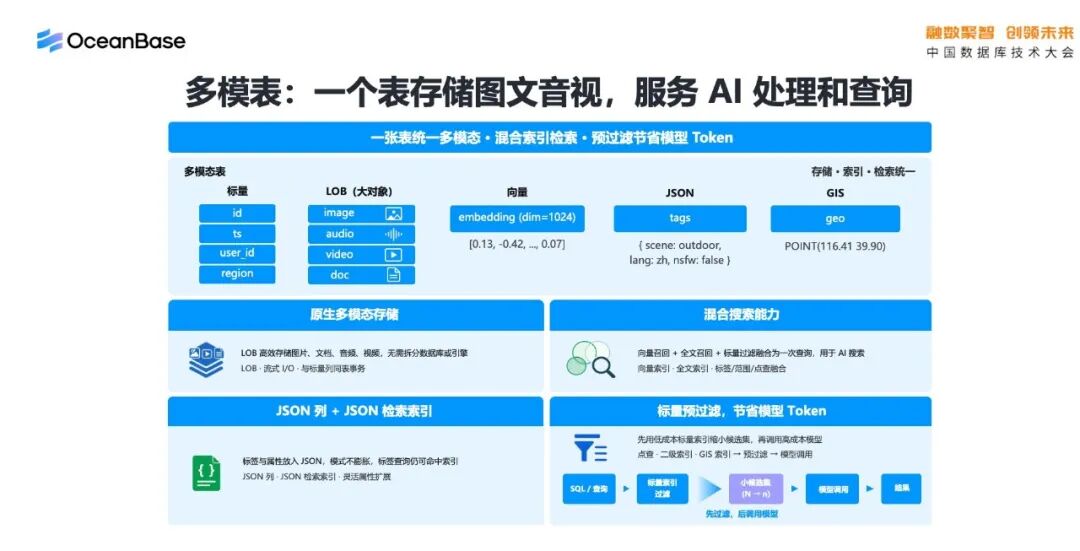
多模表的核心思路,是在传统关系型表的基础上进行扩展。
在与很多客户交流多模态数据管理与治理需求时会发现,其核心目的都是要对企业中的文本、图片、音频或摄像头视频等数据进行解析和理解,并将其转化为结构化或半结构化数据加以管理和使用。
由此自然产生一个思路:能否在同一张表中把这些信息全部对齐管理?基于这一观察,OceanBase 提供了多模表能力,主要包含以下几方面:
- 第一,具备良好的搜索能力,能够为多模态数据提供高效的混合查询;
- 第二,支持对 JSON 等半结构化数据的高效查询与检索——因为多模态数据在打标之后往往会生成半结构化数据,如何高效查询是需要解决的核心问题;
- 第三,也是最重要的一点,是针对大对象(LOB)进行了全新设计。
OceanBase 重新设计了湖库中大对象类型的实现方式,以此改变数据库圈子里“数据库不适合存储大对象”这一传统认知。在这一设计中,即便在一列里存储一个几十 GB 的视频,其读写开销也不会比存储为独立文件产生更多额外成本。
具体形态上,原始文件体量较小时以 InRow 方式直接存进数据库,体量很大时以 OutRow 方式在表中保存定位符、数据实际托管在对象存储上,由数据库统一管理元数据,用户不需要自己去维护对象与元数据之间的映射关系。
数据可分叉(Fork Database)
在此基础上,还有一个关键能力:数据库中的数据可以低成本地进行分叉(Fork Database)。
这一能力依托于 OceanBase 的存储架构以及多模表能力,可以在毫秒级完成表的复制。复制产生的新表并不会进行真正的数据拷贝,但可以在新表上执行所有增删改查操作,如同操作一张完全独立的表。
这一能力对于 Agent 评测场景意义重大。此前在应用测试领域,这一能力也曾被提及,但传统认知中测试环境与生产环境是分离的。到了 Agent 时代,情况发生了变化:Agent 的评测究竟应该基于离线数据,还是在线数据?
从实践来看,最好的解法是利用线上数据对 Agent 进行评测,这就要求 Fork 操作足够轻量——以极低成本完成 Agent 测评过程中数据沙箱的构建与快速释放。
综合来看,面向企业内部在线场景的 Agent,需要一种全新的架构。
基于湖库,可以总结出这样一种解决方案:Agent 需要能够存储其完整的上下文,这一点相对容易理解;同时,还需要存储 Agent 运行过程中产生的复杂数据,这些数据量往往很大;而 Agent 若要实现自我进化,也需要高效管理这类数据。
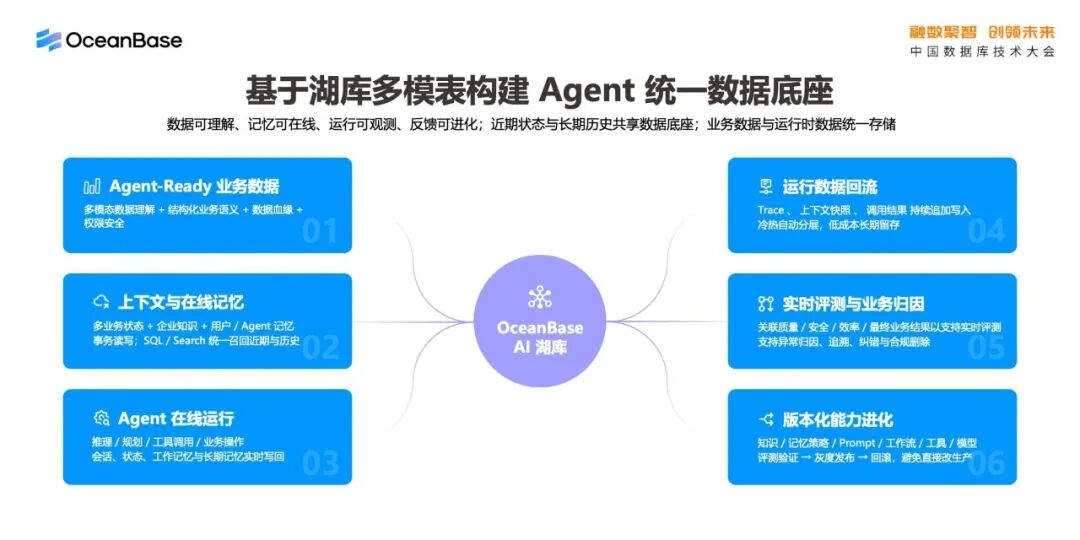
这些数据通过前面提到的 LOB 等结构来承载。运行过程中产生的所有数据,是否能够被实时、在线地分析?例如实时拦截风险、进行实时分析,并以低成本方式存储,实现在线一体化分析。
借助多模表能力,湖上的表数据可以被离线和近线引擎无缝访问,这中间需要解决数据传输的问题,这是一项关键能力。
还有一个值得提出的观点:上述内容讲的是 Agent 运行时状态与业务数据相互分离的情形。但如果 Agent 需要处理业务数据——例如面向电商商家的智能体,或类似需要处理用户健康数据的智能应用——业务数据与 Agent 运行时数据就必须打通。
因此,OceanBase 构建的整体方案,目标是让 Agent 的业务数据与运行时数据实现统一管理与交互,这也是未来 Agent 在架构和数据组织上演进的一个方向。
同时,如果数据中既包含结构化数据、也包含非结构化数据,Agent 在理解这些数据的过程中,就需要具备 Agent-Ready 的能力——也就是说,所有结构化和非结构化数据都需要具备可被 Agent 理解的业务语义。
多模态数据加工流水线
以上讲的是湖库面向在线场景的部分;而面向离线场景的工作,核心是多模态数据的加工。类似于结构化数据以分层方式加工,多模态数据也应以类似的分层方式完成加工全流程。
整体流程是:从文件或文件服务器开始,以大对象方式或文件目录方式,将数据以数据集形式管理起来,进入湖库引擎。
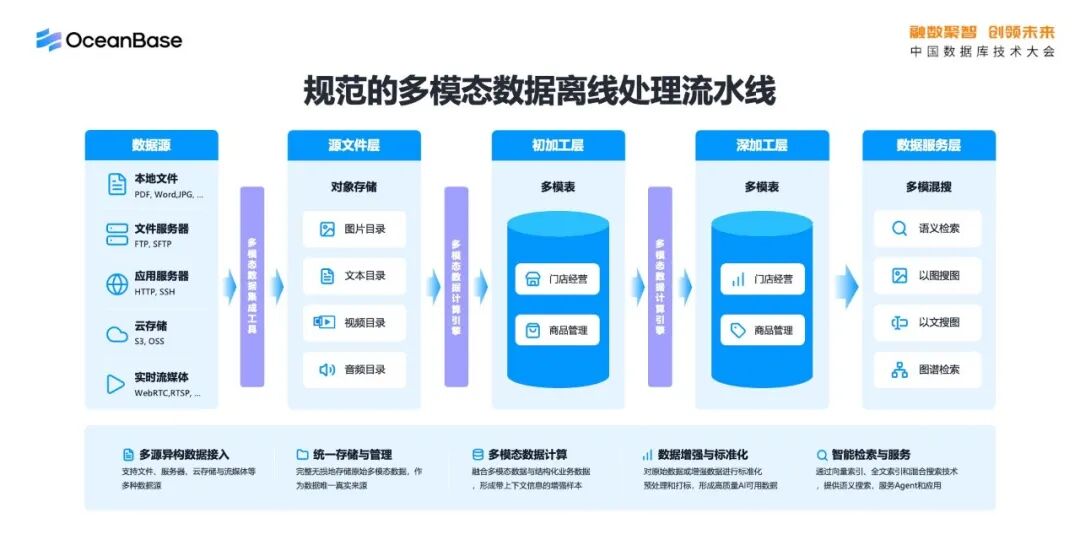
下一步,利用前面提到的各种加工能力,并引入专门的多模态数据计算引擎,结合大小模型能力对非结构化数据进行信息抽取,例如从图片中抽取信息、从文件中提取内容,完成初加工。在初加工基础上,再进行向量化(Embedding)等操作,为下一步的加工和检索使用提供支持。
最终,在数据形态上直接提供类似 Data API 的服务——可以直接查询加工好的数据,而不需要额外构建后端应用;对于文本数据,则可以直接以混合搜索方式提供查询服务。
将上述技术应用于大模型或小模型的训练,可以围绕多模表构建一套加工流程:一张大表中,一部分数据是原始待加工样本,以 LOB 列形式存储在表中;加工清洗过程,则是通过 CPU 或 GPU 等方式,对这些数据不断提取特征,形成多模表中各种类型的新增列。
在此基础上进行清洗、加工、标注(包括人工标注和自动化标注)。
标注完成后,对整个多模表执行一次 Fork 操作,完成数据快照;快照完成后再进行版本管理,之后数据即可推送到训练集群进行训练。
由于所有多模态数据都具备版本可追溯性,当需要分析 V1 版本模型与 V2 版本模型效果提升或下降的原因时,可以准确追溯到具体的数据变化。
最后,基于湖库引擎,在更上层还构建了一个平台级产品——OceanBase DataStudio。
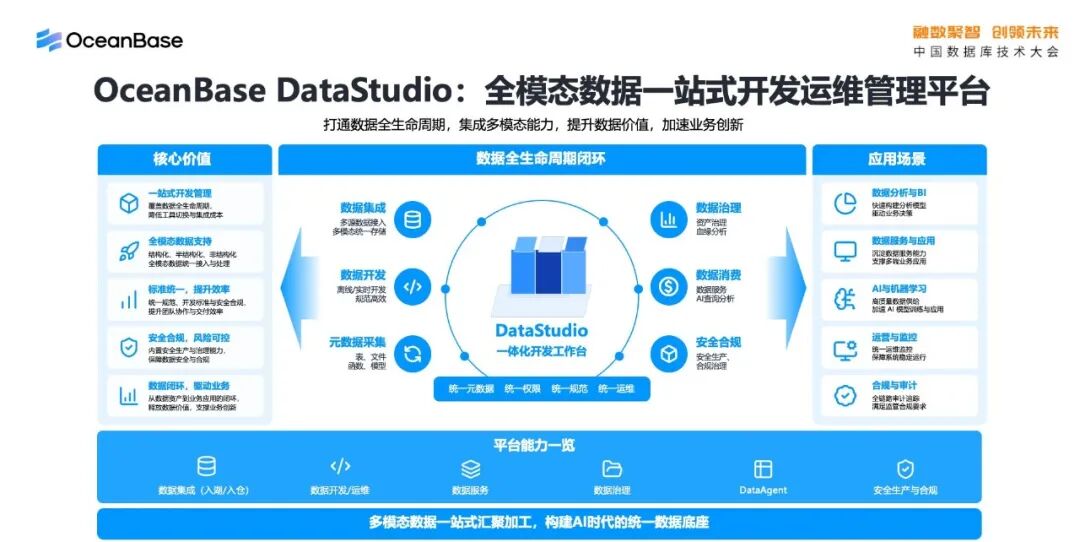
对于独立的数据开发从业者而言,这一产品应该比较容易理解。
它面向多模态数据,涵盖从数据集成开始,如何通过工具完成数据加工,如何对多模态数据进行数据血缘的追踪与管理,以及在构建出高质量数据集之后,如何在企业内部进行推广、共享和使用,完成数据资产管理、数据质量管理,以及加工过程中的运维等诸多工作。
从架构上看,DataStudio 兼顾结构化数据和非结构化数据的处理。通过多模表技术,结构化数据与非结构化数据在用户的开发和使用概念中不需要分别学习两套知识体系,只需掌握约 1.2 倍的知识量,就能从原本只做结构化数据管理和开发的数据开发人员,升级为能够高效为企业构建高质量数据集的、能力更强的角色。
此外,整个平台提供了一整套数据 Agent 能力,使开发人员可以在企业内部直接调用最适合自身研发流程的技能与工具。对于企业内部所有数据资产的选择、ETL 开发,也比以往更加简便,同时降低了对具体开发语言的依赖,这也是一个关键变化。
在企业构建起数据语义体系之后,还可以以“智能问数”的方式对已加工好的数据直接生成应用,实现数据价值的进一步释放。
对于长期关注 OceanBase 的人来说,这确实是一次比较大的变化。但回看过去十余年,它又是自然的:OceanBase 始终以企业的实际问题为驱动,一步步走到今天。
从分布式数据库到 AI 湖库,变的是能装下的数据类型和能支撑的业务场景,不变的是“用一套一体化的引擎,为企业提供高性价比的数据底座”这件事本身。

往期内容推荐
了解更多
添加社区小助手,加入微信交流群~