#创建unit资源规格CREATE RESOURCE UNIT unit1 MAX_CPU 4, MEMORY_SIZE '8G'; #创建resource pool资源池CREATE RESOURCE POOL pool1 UNIT='unit1', UNIT_NUM=1, ZONE_LIST=('zone1','zone2','zone3'); #创建test租户CREATE TENANT test PRIMARY_ZONE='zone1,zone2,zone3', RESOURCE_POOL_LIST=('pool1'), CHARSET='utf8mb4'SET ob_tcp_invited_nodes TO'%';
检查租户。
1
2
3
SELECT tenant_id, tenant_name, tenant_type, primary_zone, status ,tenant_role,COMPATIBILITY_MODE FROM dba_ob_tenants; obclient [oceanbase]>SELECT tenant_id, tenant_name, tenant_type, primary_zone, status ,tenant_role FROM dba_ob_tenants; +-----------+-------------+-------------+-------------------+--------+-------------+| tenant_id | tenant_name | tenant_type | primary_zone | status | tenant_role |+-----------+-------------+-------------+-------------------+--------+-------------+| 1 | sys | SYS | RANDOM | NORMAL | PRIMARY || 1003 | META$1004 | META | zone1,zone2,zone3 | NORMAL | PRIMARY || 1004 | test | USER | zone1,zone2,zone3 | NORMAL | PRIMARY |+-----------+-------------+-------------+-------------------+--------+-------------+3 rows in set (0.022 sec)
设置测试租户的 root 用户密码和测试账户信息。
1 2 3 4 5 6 7 8 9 10
obclient -h192.0.2.13 -P2883 -uroot@test#obcluster -p -Doceanbase -c -AEnter password: Welcome to the OceanBase. Commands end with ; or \g.Your OceanBase connection id is 816Server version: OceanBase 4.2.1.3 (r103030022024011313-c6afef2be5748fc54b1b0159b5224ae288491424) (Built Jan 13 2024 13:36:43) Copyright (c) 2000, 2018, OceanBase and/or its affiliates. All rights reserved. Type 'help; ' or '\h'forhelp. Type '\c' to clear the current input statement. obclient [oceanbase]> set password=password('<YOUR_PASSWORD>'); Query OK, 0 rows affected (0.081 sec) obclient [oceanbase]> create user tuser identified by '<YOUR_PASSWORD>'; Query OK, 0 rows affected (0.064 sec) obclient [oceanbase]> grant all privileges on *.* to tuser; Query OK, 0 rows affected (0.088 sec)
[root@server64 soft]# sysbench oltp_read_write --mysql-host=192.0.2.13 --mysql-port=2883 --mysql-user=tuser@test#obcluster --mysql-password=<YOUR_PASSWORD> --mysql-db=test --db-ps-mode=disable --report-interval=10 --mysql-ignore-errors=6002,6004,4012,2013,4016 --tables=3 --table_size=999999 --threads=10 --time=180 preparesysbench 1.0.17 (using system LuaJIT 2.0.4) Initializing worker threads... Creating table'sbtest1'...Creating table'sbtest2'...Creating table'sbtest3'...Inserting 999999 records into'sbtest2'Inserting 999999 records into'sbtest3'Inserting 999999 records into'sbtest1'Creating a secondary index on'sbtest1'...Creating a secondary index on'sbtest3'...Creating a secondary index on'sbtest2'...
查看测试表的位置分布。
1
2
3
obclient -h192.0.2.13 -P2883 -uroot@test#obcluster -p<YOUR_PASSWORD> -Doceanbase -c -A select table_name, partition_name, svr_ip, role from oceanbase.dba_ob_table_locations where database_name='test' and table_name like 'sbtest%' and role='leader' order by 2,1; +------------+----------------+-----------+--------+| table_name | partition_name | svr_ip | role |+------------+----------------+-----------+--------+| sbtest1 | NULL | 192.0.2.11 | LEADER || sbtest2 | NULL | 192.0.2.12 | LEADER || sbtest3 | NULL | 192.0.2.13 | LEADER |+------------+----------------+-----------+--------+3 rows inset (0.121 sec)
2.1.2 研究执行计划
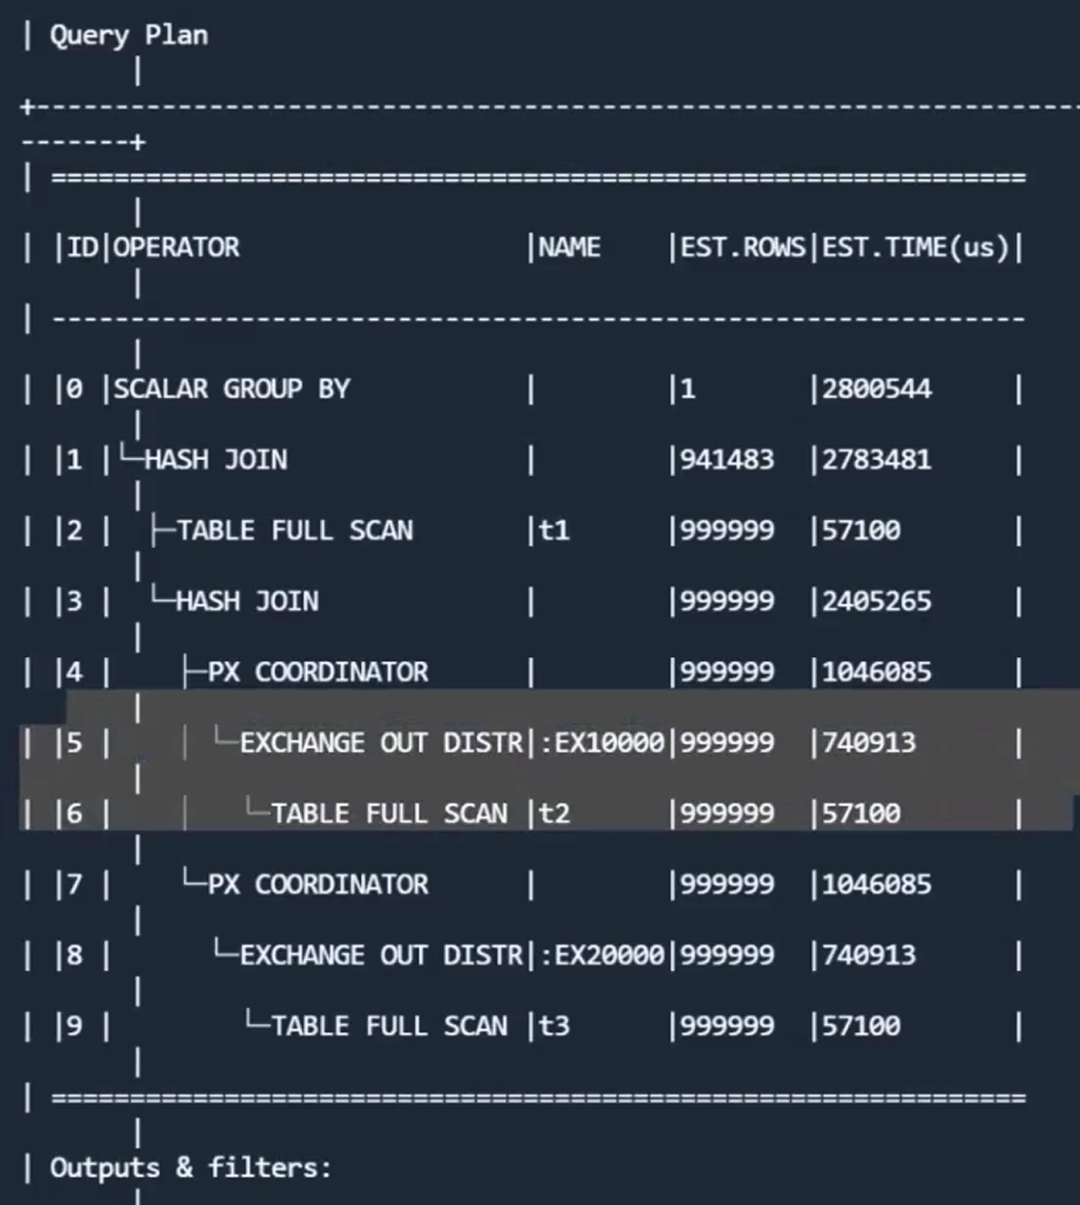
查看分布式执行计划
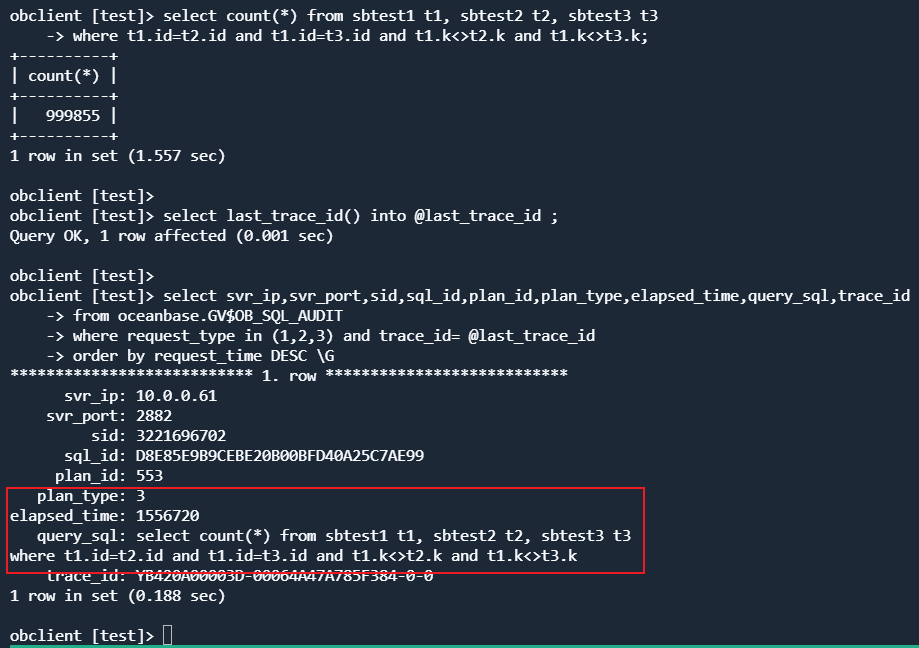
实验主要就是看下面这个三表连接的执行计划。
1 2
obclient -h192.0.2.13 -P2883 --utuser@test#obcluster -p<YOUR_PASSWORD> -Dtest -c -A EXPLAIN EXTENDED select count(*) from sbtest1 t1, sbtest2 t2, sbtest3 t3 where t1.id=t2.id and t1.id=t3.id and t1.k<>t2.k and t1.k<>t3.k;
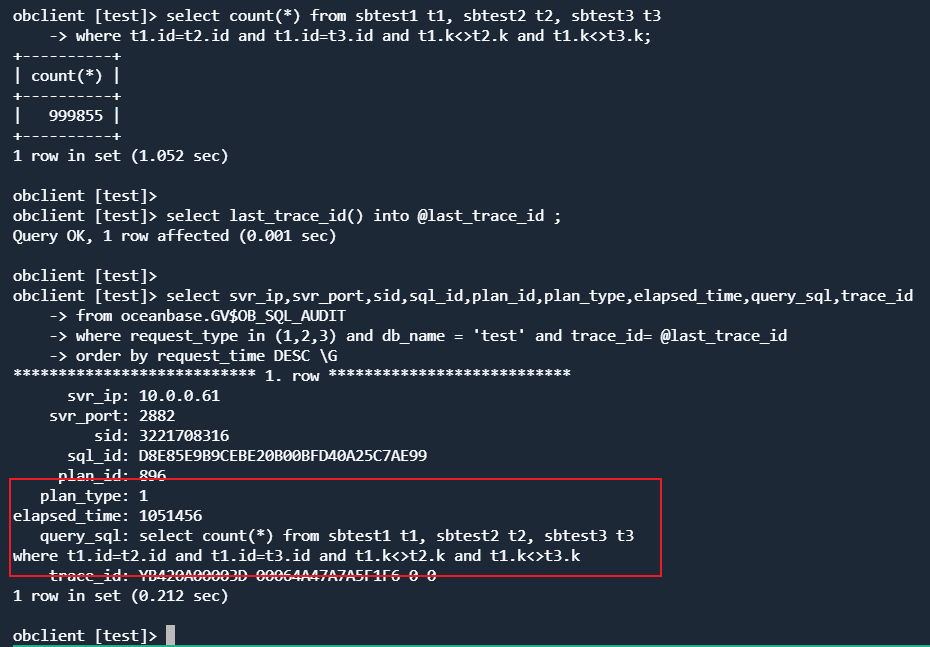
set@last_trace_id=''; selectcount(*) from sbtest1 t1, sbtest2 t2, sbtest3 t3 where t1.id=t2.id and t1.id=t3.id and t1.k<>t2.k and t1.k<>t3.k; select last_trace_id() into@last_trace_id ; select svr_ip,svr_port,sid,sql_id,plan_id,plan_type,elapsed_time,query_sql,trace_id from oceanbase.GV$OB_SQL_AUDIT where request_type in (1,2,3) and db_name ='test'and trace_id=@last_trace_idorderby request_time DESC \G
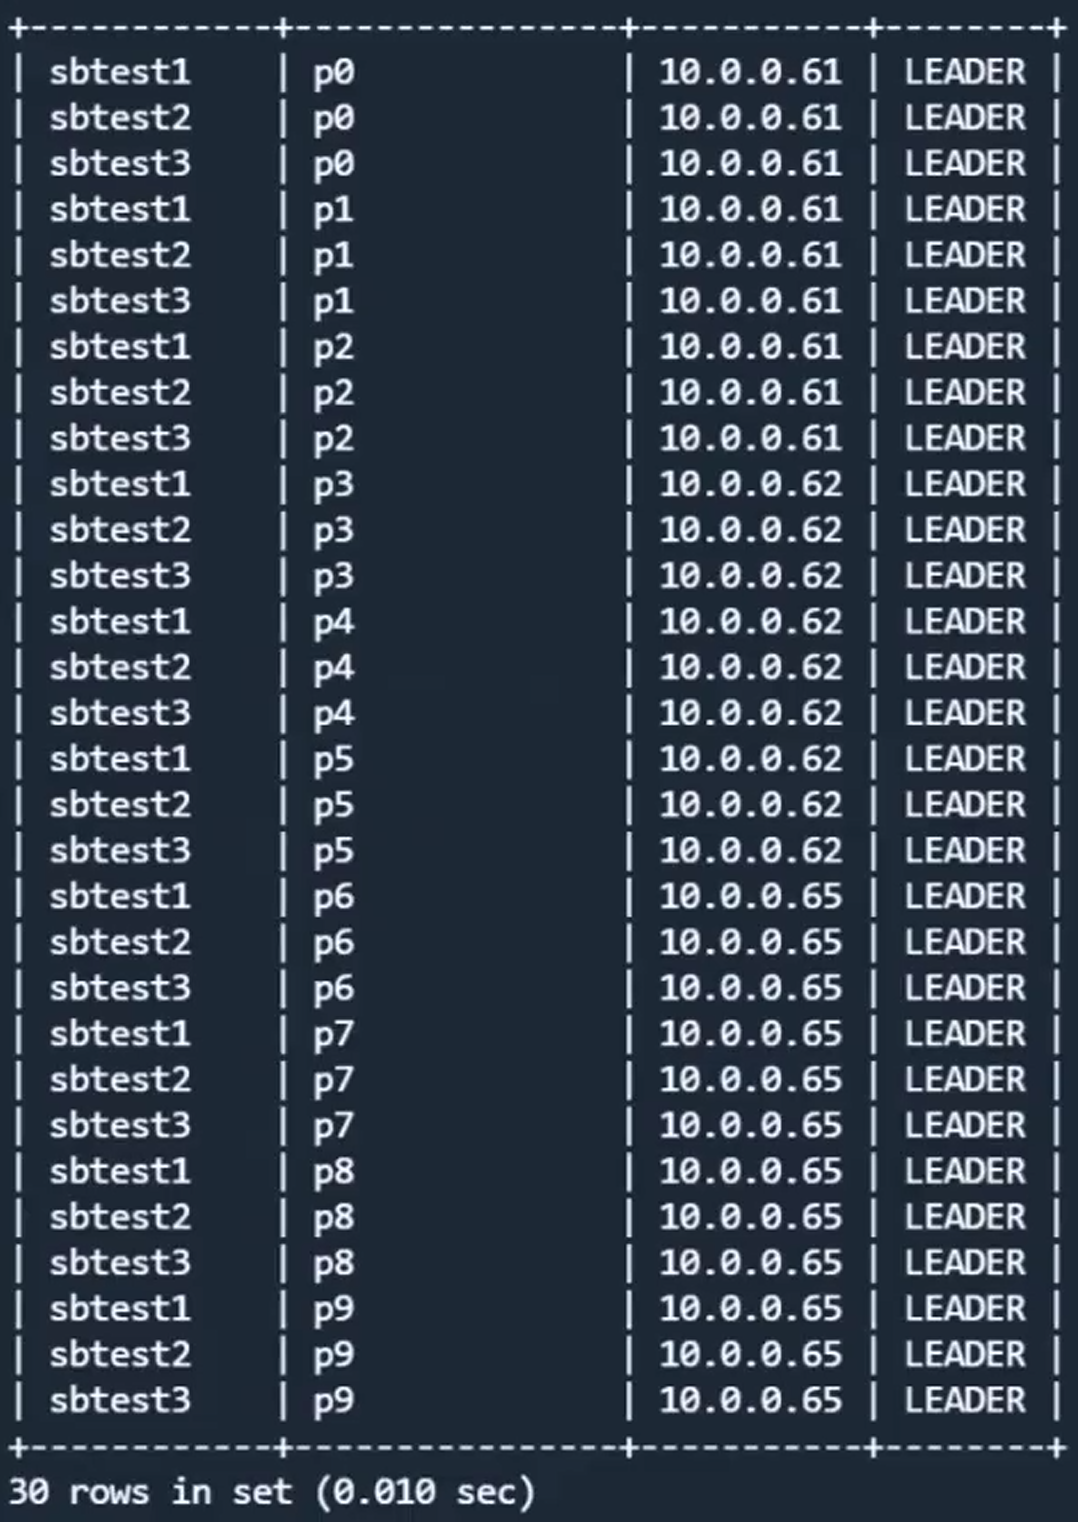
#在改变分区规则前,先将sbtest1,sbtest2,sbtest3从原来的表组中删除: altertable sbtest1 set tablegroup=''; altertable sbtest2 set tablegroup=''; altertable sbtest3 set tablegroup=''; #创建sharding='PARTITION'的表组: createtablegroup tbg2 sharding='PARTITION'; #修改sbtest1,sbtest2,sbtest3为hash分区表: altertable sbtest1 partitionby hash(id) partitions 9; altertable sbtest2 partitionby hash(id) partitions 9; altertable sbtest3 partitionby hash(id) partitions 9; #将sbtest1,sbtest2,sbtest3加入到新的表组: altertablegroup tbg2 addtable sbtest1,sbtest2,sbtest3; #等待20秒,让自动负载均衡完成分区均衡: select/*+ query_timeout(60000000)*/ sleep(20); #查看负载均衡的结果,三张表的相同分区汇聚在了一起,不同分区分散到3台OBServer上: select table_name, partition_name, svr_ip, role from oceanbase.dba_ob_table_locations where database_name='test'and table_name like'sbtest%'and role='leader'orderby2,1;
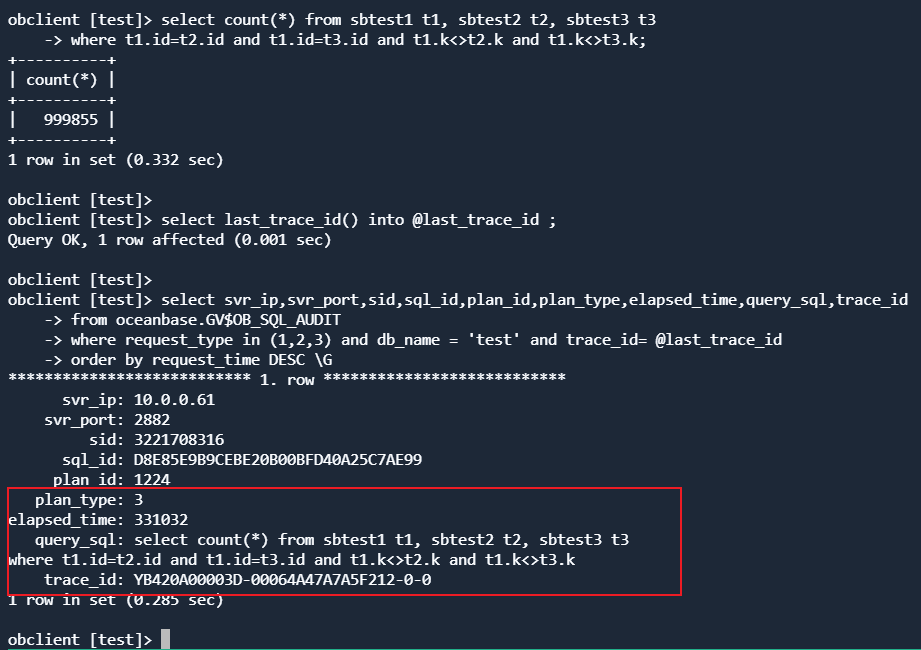
再次看 SQL 的执行计划。
1 2 3 4 5
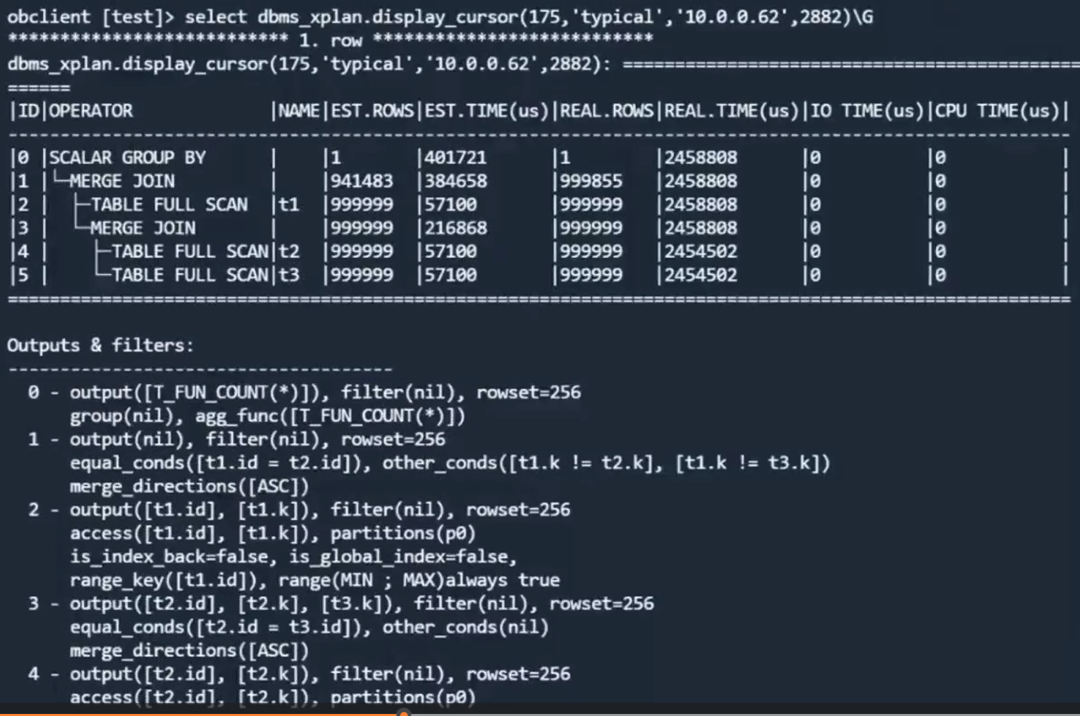
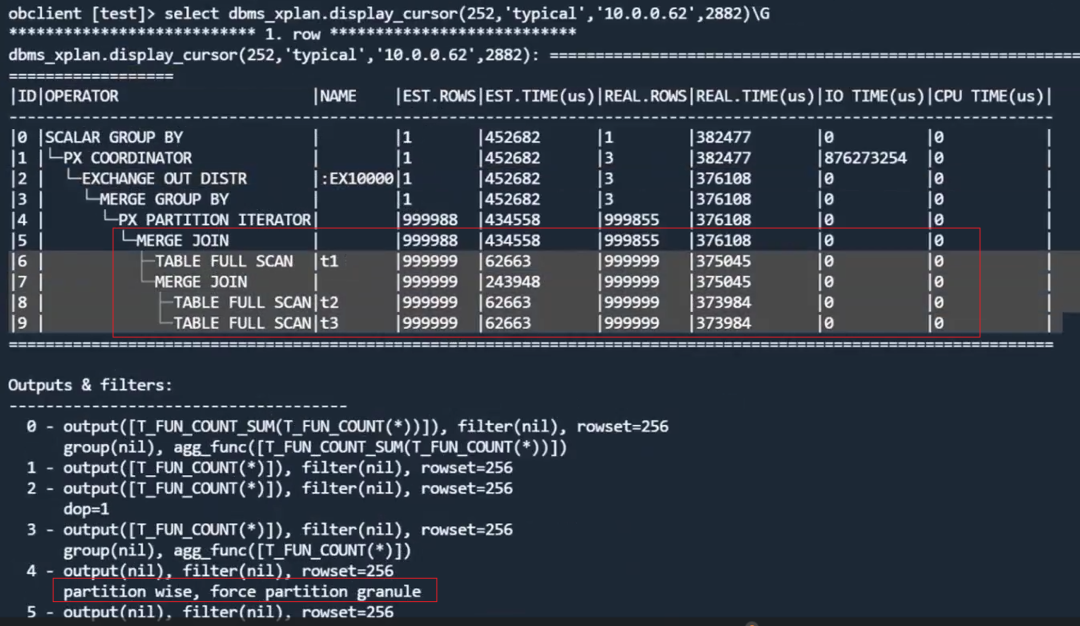
set@last_trace_id=''; selectcount(*) from sbtest1 t1, sbtest2 t2, sbtest3 t3 where t1.id=t2.id and t1.id=t3.id and t1.k<>t2.k and t1.k<>t3.k; select last_trace_id() into@last_trace_id ; select svr_ip,svr_port,sid,sql_id,plan_id,plan_type,elapsed_time,query_sql,trace_id from oceanbase.GV$OB_SQL_AUDIT where request_type in (1,2,3) and db_name ='test'and trace_id=@last_trace_idorderby request_time DESC \G select dbms_xplan.display_cursor(1224,'typical','192.0.2.13',2882);
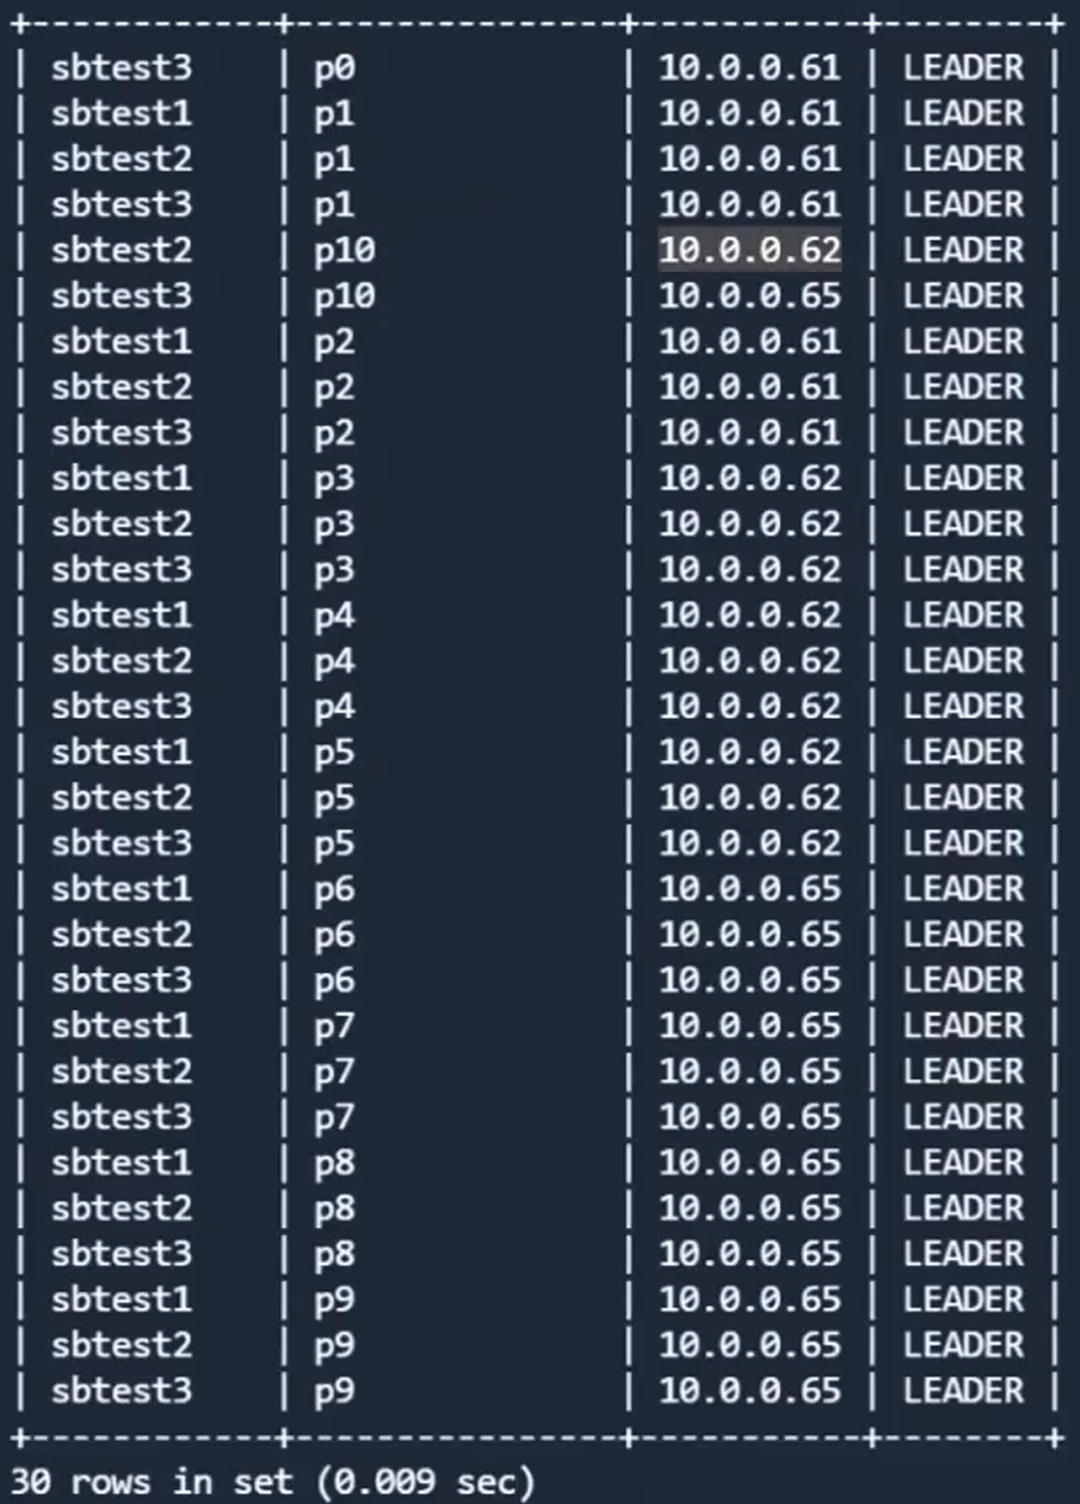
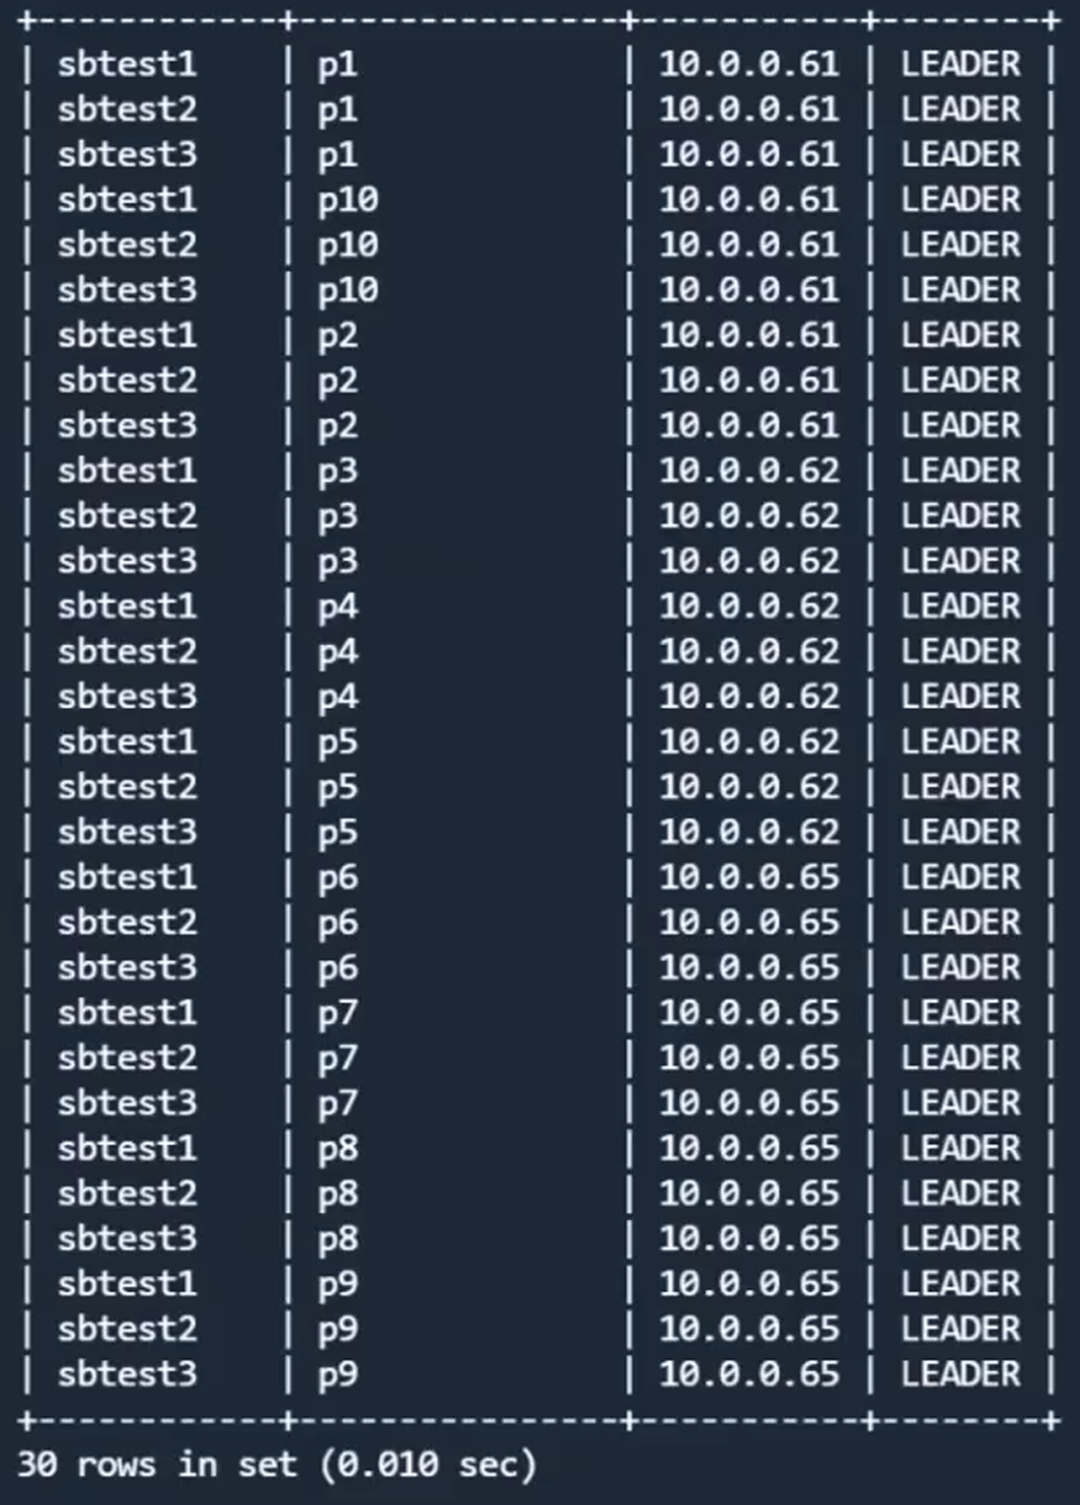
#在改变分区规则前,先将sbtest1,sbtest2,sbtest3从表组tbg2中删除: altertable sbtest1 set tablegroup=''; altertable sbtest2 set tablegroup=''; altertable sbtest3 set tablegroup=''; #修改sbtest1,sbtest2,sbtest3为range分区表: altertable sbtest1 partitionbyrange(id)(partition p0 values less than (100000),partition p1 values less than (200000),partition p2 values less than (300000),partition p3 values less than (400000),partition p4 values less than (500000),partition p5 values less than (600000),partition p6 values less than (700000),partition p7 values less than (800000),partition p8 values less than (900000),partition p9 values less than (1000000)); altertable sbtest2 partitionbyrange(id)(partition p0 values less than (100000),partition p1 values less than (200000),partition p2 values less than (300000),partition p3 values less than (400000),partition p4 values less than (500000),partition p5 values less than (600000),partition p6 values less than (700000),partition p7 values less than (800000),partition p8 values less than (900000),partition p9 values less than (1000000)); altertable sbtest3 partitionbyrange(id)(partition p0 values less than (100000),partition p1 values less than (200000),partition p2 values less than (300000),partition p3 values less than (400000),partition p4 values less than (500000),partition p5 values less than (600000),partition p6 values less than (700000),partition p7 values less than (800000),partition p8 values less than (900000),partition p9 values less than (1000000)); #将sbtest1,sbtest2,sbtest3重新加回表组: altertablegroup tbg2 addtable sbtest1,sbtest2,sbtest3; #等待20秒,让自动负载均衡完成分区均衡: select/*+ query_timeout(60000000)*/ sleep(20); #查看负载均衡的结果,三张表的相同分区汇聚在了一起,不同分区分散到3台OBServer上: select table_name, partition_name, svr_ip, role from oceanbase.dba_ob_table_locations where database_name='test'and table_name like'sbtest%'and role='leader'orderby2,1;
altertable sbtest1 addcolumn (name char(30) before k,age int before k) ; showcreatetable sbtest1\G DROPPROCEDURE IF EXISTS UPDATE_NEW_COLUMNS ; DELIMITER // CREATEPROCEDURE UPDATE_NEW_COLUMNS( IN tableName VARCHAR(255) )BEGINDECLARE i INTDEFAULT1; DECLARE name_value CHAR(30) DEFAULT' '; DECLARE age_value INTDEFAULT1; DECLARE names_array VARCHAR(255) DEFAULT'John,Mary,David,Linda,James,Susan,Robert,Karen,Michael,Lisa,William,Nancy,Richard,Betty,Charles,Margaret,Joseph,Dorothy,Thomas,Sandra'; DECLARE name_index INT; WHILE i <=40 DOSET name_index =FLOOR(RAND() *20) +1; -- 生成 1 到 20 之间的随机索引SET name_value = SUBSTRING_INDEX(SUBSTRING_INDEX(names_array, ',',name_index), ',', -1); SET age_value =FLOOR(RAND() *50) +18; -- 生成 18 到 67 之间的随机年龄SET @sql = CONCAT('UPDATE ', tableName, ' SET name="', name_value, '", age = ', age_value, ' WHERE id%40 = ', i-1); PREPARE stmt FROM@sql; EXECUTE stmt; DEALLOCATEPREPARE stmt; COMMIT; SET i = i +1; END WHILE; END// DELIMITER ;
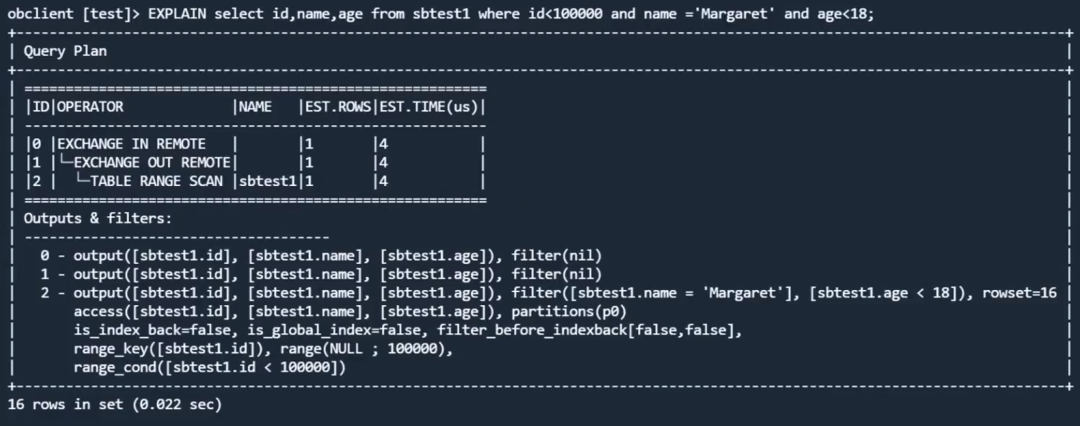
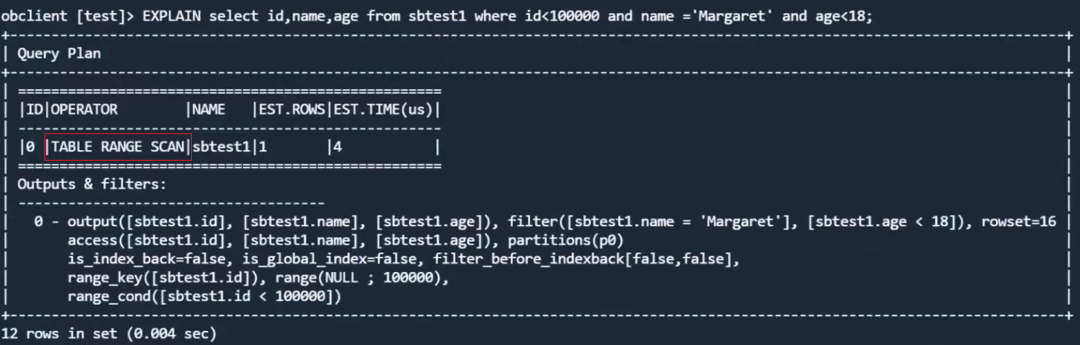
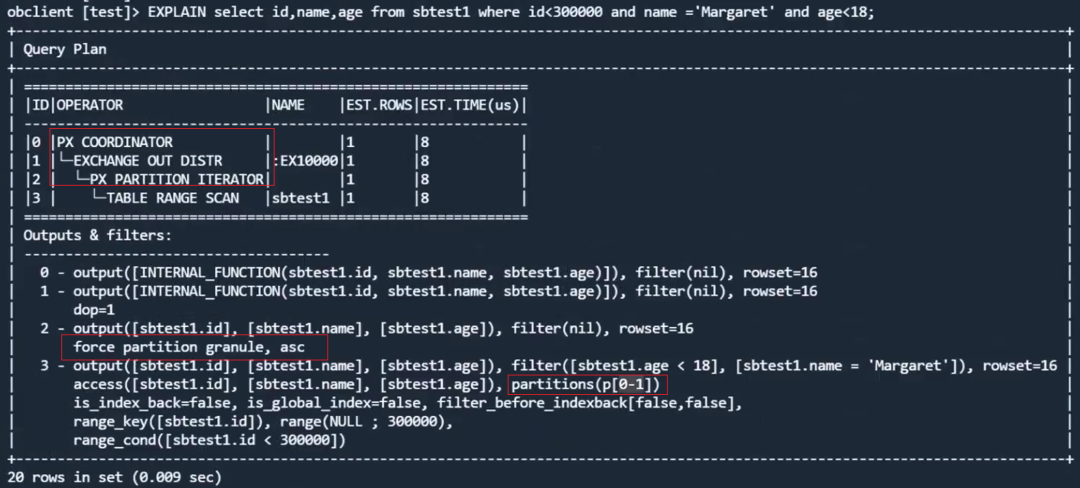
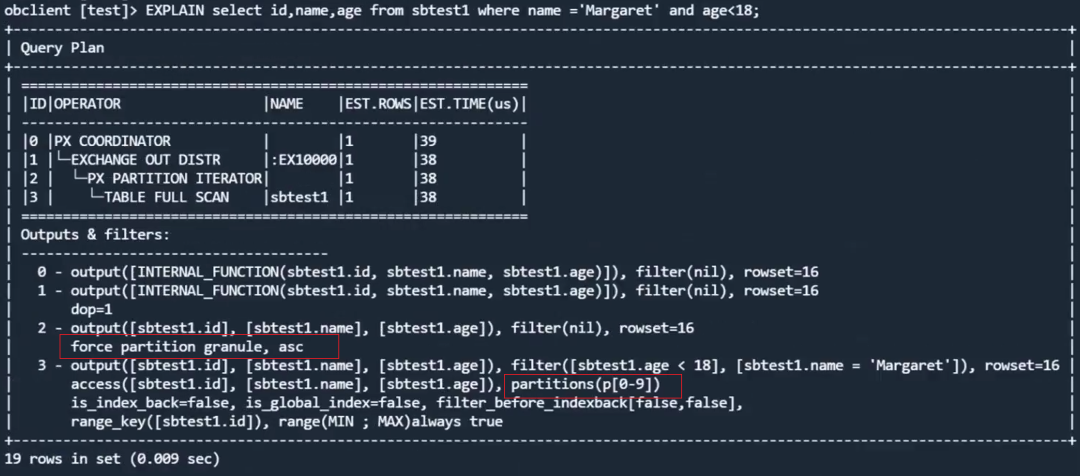
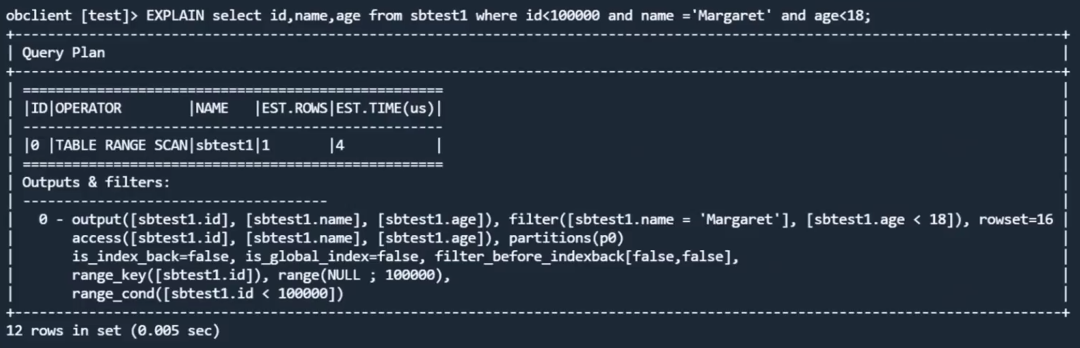
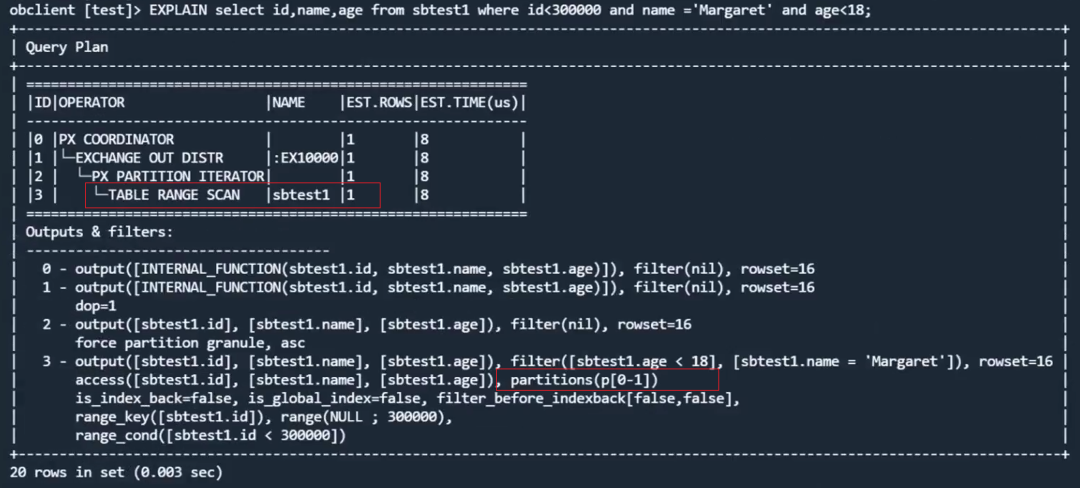
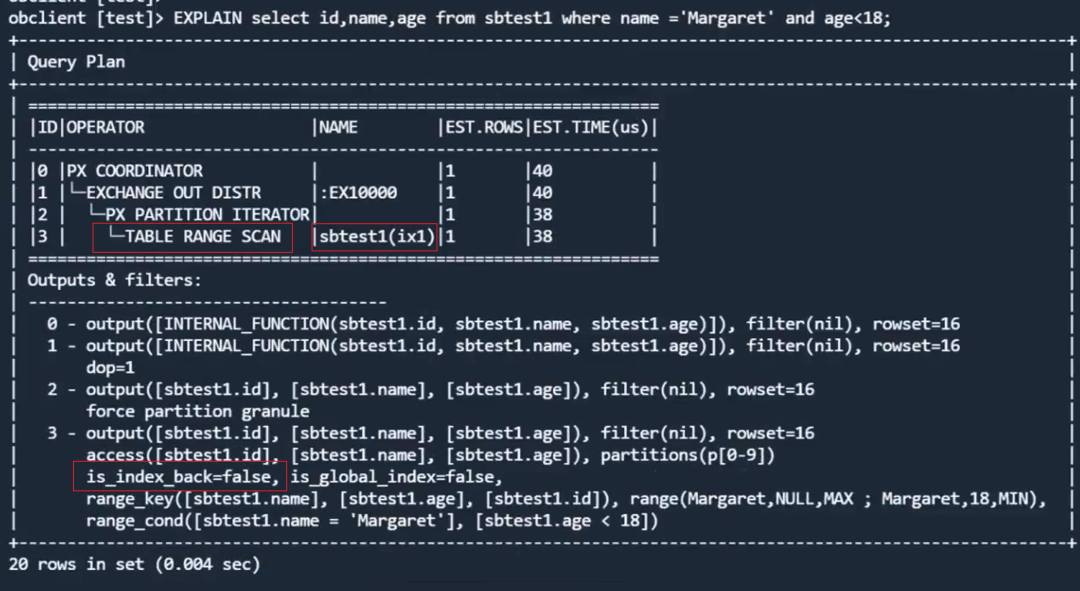
#调用存储过程,执行批量更新CALL UPDATE_NEW_COLUMNS('sbtest1'); SELECT NAME,COUNT(*) FROM sbtest1 GROUPBY NAME; +----------+----------+| NAME | COUNT(*) |+----------+----------+| Michael | 22500 || William | 67500 || Susan | 112500 || Dorothy | 112500 || Nancy | 67500 || Betty | 45000 || Thomas | 45000 || Margaret | 22500 || Mary | 67500 || Lisa | 45000 || Linda | 67500 || Karen | 45000 || Robert | 22500 || Joseph | 45000 || Sandra | 22500 || James | 45000 || Richard | 45000 |+----------+----------+17 rows in set (0.492 sec) EXPLAIN select id,name,age from sbtest1 where id<100000and name ='Margaret'and age<18; EXPLAIN select id,name,age from sbtest1 where id<300000and name ='Margaret'and age<18; EXPLAIN select id,name,age from sbtest1 where name ='Margaret'and age<18;
create index ix1 on sbtest1 (name,age) LOCAL; create index ix2 on sbtest1 (age,name) LOCAL; create index ix3 on sbtest1 (id,name,age) LOCAL;
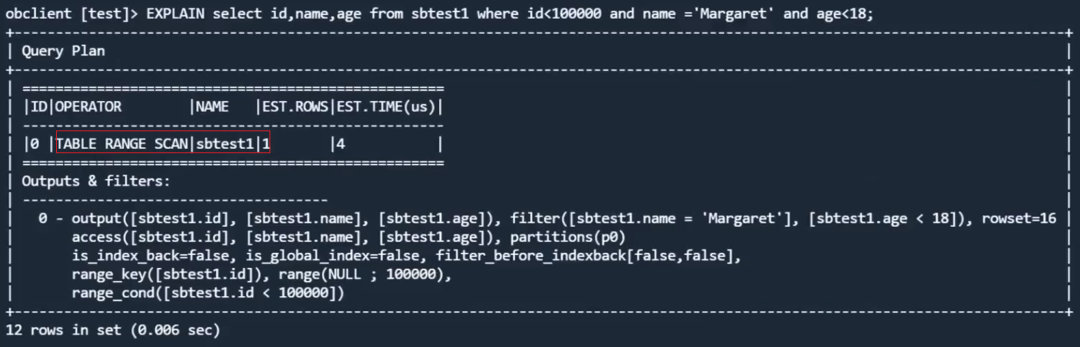
第一个 SQL 执行计划不变,依然走主键扫描。因为这个条件下去没有数据返回,主键扫描成本更低。
第二个 SQL 执行计划也没变,这个跟实验材料有些区别。可能跟数据分布和统计信息有关。
第三个 SQL 执行计划发生变化,选了本地索引。依然有并行,还是分布式执行计划。is_global_index=false, 表示是本地索引;is_index_back=false,表示没有索引回表,因为索引列包含了主键 id 列。
2.2.3 全局索引测试
再加一个全局索引。注意:MySQL 租户允许列上有重复的索引,ORACLE 租户不允许。
1
create index ix1_g on sbtest1 (name,age) GLOBAL;
再看三个 SQL 的执行计划。
第一个 SQL 执行计划不变,因为有分区裁剪,且没有数据,所以不需要全局索引。
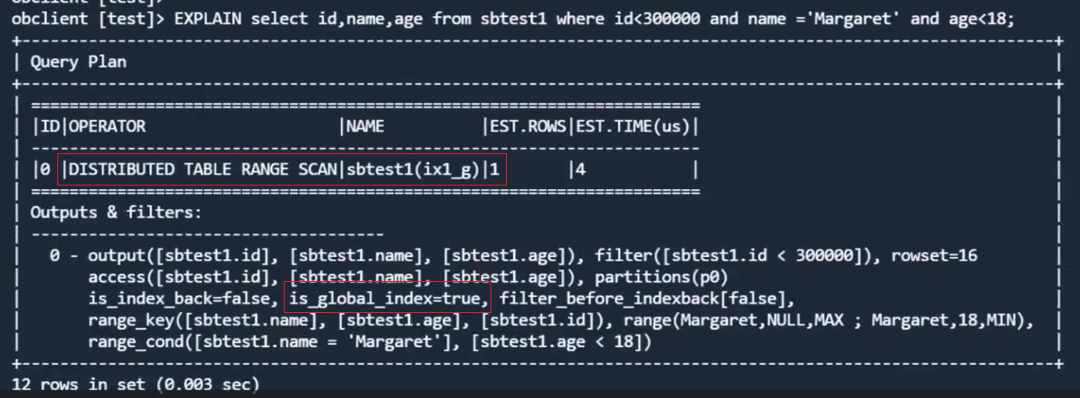
第二个 SQL 执行计划变为走全局索引了,看起来是本地执行计划,实际上是用了 DAS ,此时屏蔽了存储层的取数据行为,所以看不出来是分布式执行计划了。is_global_index=true 表示是全局索引,is_index_back=false 表示没有索引回表。
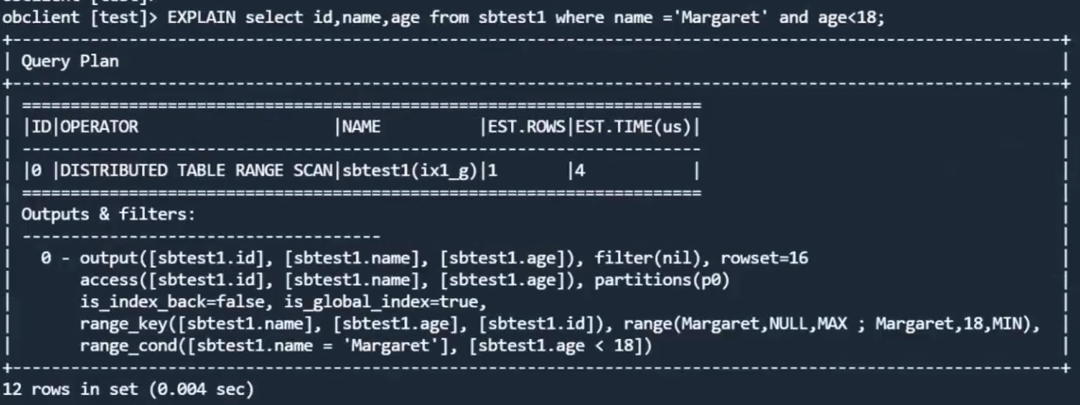
第三个 SQL 执行计划也变为走全局索引,也用了 DAS。
3. 实验 2:SQL 执行优化
3.1 执行计划管理
3.1.1 Outline 测试
1 2
obclient -h192.0.2.11 -uroot@test#obcluster -P2883 -p<YOUR_PASSWORD> -c -A test EXPLAIN EXTENDED select/*+ index(sbtest1 ix1_g)*/ id,name,age from sbtest1 whereid<100000 and name ='Margaret' and age<18;EXPLAIN EXTENDED select/*+ index(sbtest1 ix1_g)*/ id,name,age from sbtest1 whereid<300000 and name ='Margaret' and age<18;EXPLAIN EXTENDED select/*+ index(sbtest1 ix1_g)*/ id,name,age from sbtest1 where name ='Margaret' and age<18;
首先查看三个 SQL 的 Hint 执行计划中的 OUTLINE DATA 。
1 2
use test;EXPLAIN EXTENDED select/*+ index(sbtest1 ix1_g)*/ id,name,age from sbtest1 whereid<300000 and name ='Margaret' and age<18; Outline Data: ------------------------------------- /*+ BEGIN_OUTLINE_DATA INDEX(@"SEL$1""test"."sbtest1"@"SEL$1""ix1_g") USE_DAS(@"SEL$1""test"."sbtest1"@"SEL$1") OPTIMIZER_FEATURES_ENABLE('4.2.1.0') END_OUTLINE_DATA */
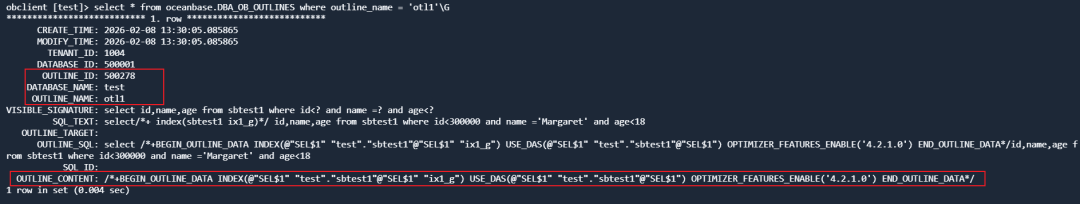
create outline otl1 onselect/*+ index(sbtest1 ix1_g)*/ id,name,age from sbtest1 where id<300000and name ='Margaret'and age<18; select*from oceanbase.DBA_OB_OUTLINES where outline_name ='otl1'\G
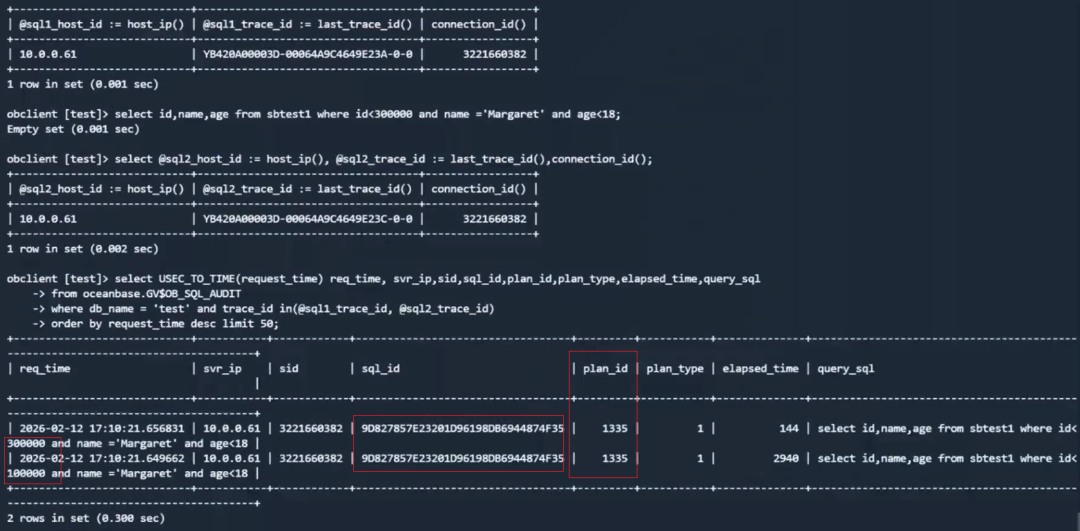
OUTLINE 创建成功后,再看看 SQL 是否使用到 OUTLINE 。
1 2 3 4 5 6
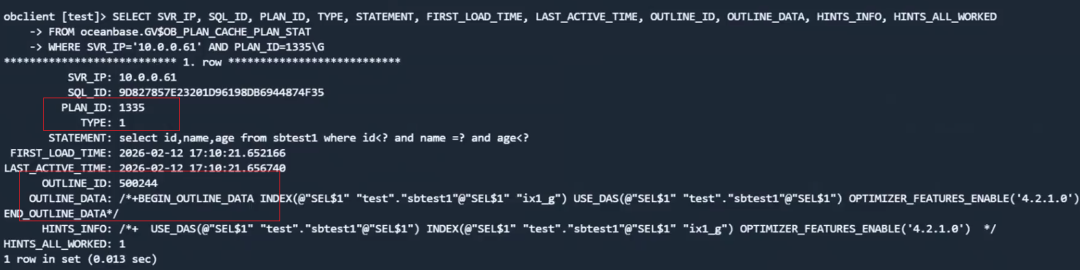
select id,name,age from sbtest1 where id<100000and name ='Margaret'and age<18; select@sql1_host_id := host_ip(), @sql1_trace_id := last_trace_id(),connection_id(); select id,name,age from sbtest1 where id<300000and name ='Margaret'and age<18; select@sql2_host_id := host_ip(), @sql2_trace_id := last_trace_id(),connection_id(); select USEC_TO_TIME(request_time) req_time, svr_ip,sid,sql_id,plan_id,plan_type,elapsed_time,query_sql from oceanbase.GV$OB_SQL_AUDIT where db_name ='test'and trace_id in(@sql1_trace_id, @sql2_trace_id)orderby request_time desc limit 50; SELECT SVR_IP, SQL_ID, PLAN_ID, TYPE, STATEMENT, FIRST_LOAD_TIME, LAST_ACTIVE_TIME, OUTLINE_ID, OUTLINE_DATA, HINTS_INFO, HINTS_ALL_WORKED FROM oceanbase.GV$OB_PLAN_CACHE_PLAN_STAT WHERE SVR_IP='192.0.2.11'AND PLAN_ID=1824 \G
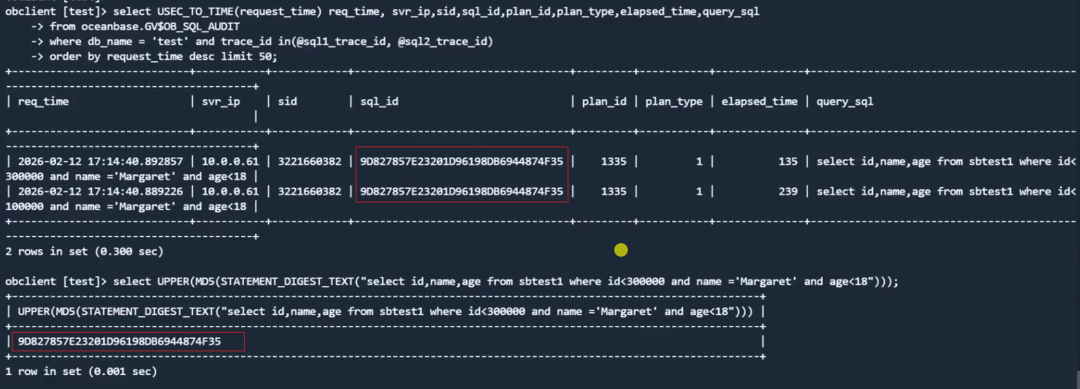
# STATEMENT_DIGEST_TEXT获得参数化的文本,MD5生成SQL_ID,UPPER转化为大写selectUPPER(MD5(STATEMENT_DIGEST_TEXT("select id,name,age from sbtest1 where name ='Margaret' and age<18"))); # or select id,name,age from sbtest1 where name ='Margaret'and age<18; select@sql3_host_id := host_ip(), @sql3_trace_id := last_trace_id(),connection_id(); select svr_ip,svr_port,sid,sql_id,plan_id,plan_type,elapsed_time,query_sql from oceanbase.GV$OB_SQL_AUDIT where trace_id=@sql3_trace_id ;
注:我这个图的 SQL 跟上面 SQL 不一致,所以结果跟实验材料不一致。
1 2
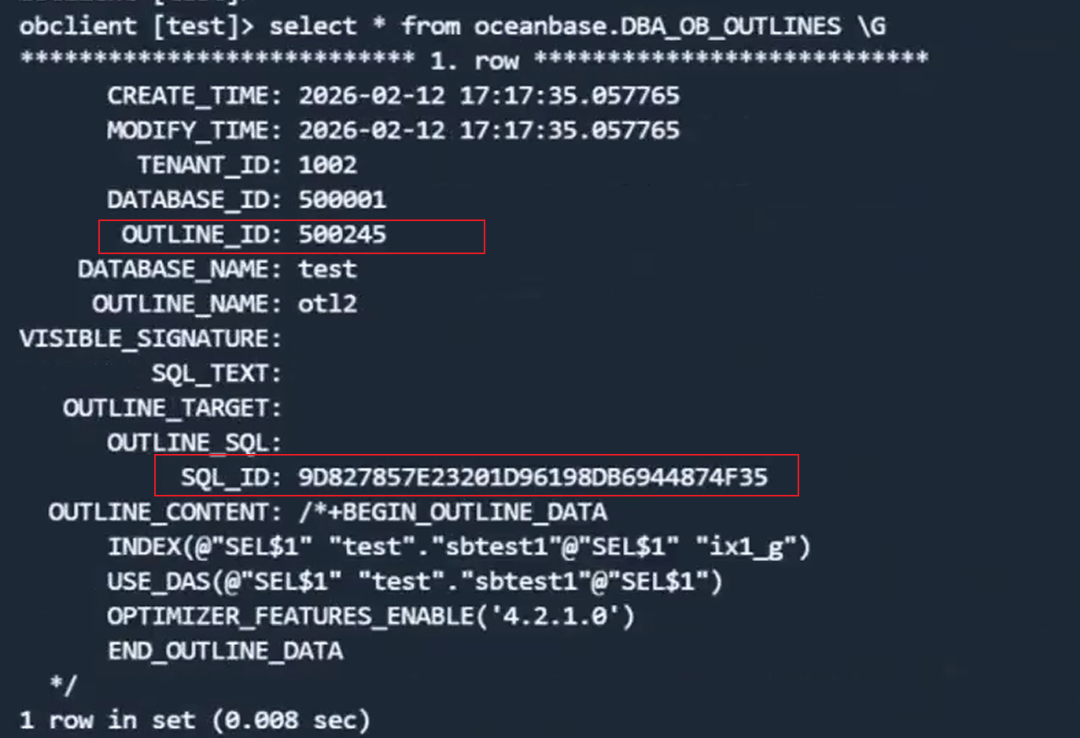
如果你的结果显示两个值不一致,则可能跟 OB 版本有关。这个了解即可,我不建议通过 STATEMENT_DIGEST_TEXT 去生成 SQL_ID 。 接下来演示通过 SQL_ID 和 OUTLINE_DATA 来创建 OUTLINE 。create outline otl2 on "9D827857E23201D96198DB6944874F35" using hint /*+ BEGIN_OUTLINE_DATA INDEX(@"SEL$1" "test"."sbtest1"@"SEL$1" "ix1_g") USE_DAS(@"SEL$1" "test"."sbtest1"@"SEL$1") OPTIMIZER_FEATURES_ENABLE('4.2.1.0') END_OUTLINE_DATA */ ;select * from oceanbase.DBA_OB_OUTLINES where outline_name='otl2'\G;
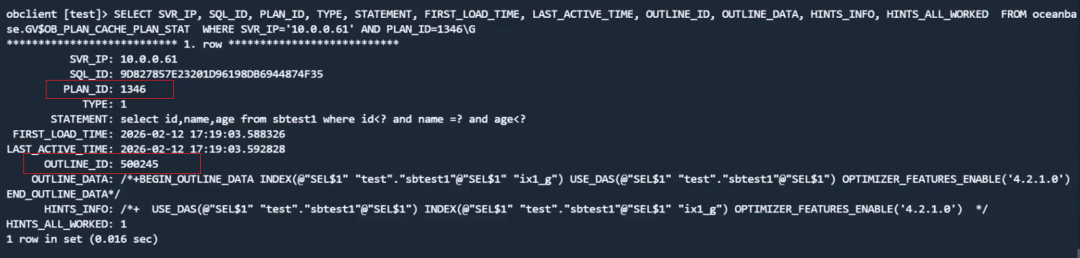
查看 SQL_ID 对应的执行计划缓存,也看到了使用了这个 OUTLINE_ID 。
实验做完后,清理相关索引和 OUTLINE 。
1 2 3 4 5 6 7 8
drop index ix1 on sbtest1; drop index ix2 on sbtest1; drop index ix3 on sbtest1; drop index ix1_g on sbtest1; drop outline otl1; drop outline otl2; SELECT*FROM oceanbase.DBA_OB_OUTLINES; SELECT*FROM oceanbase.DBA_SQL_MANAGEMENT_CONFIG ;
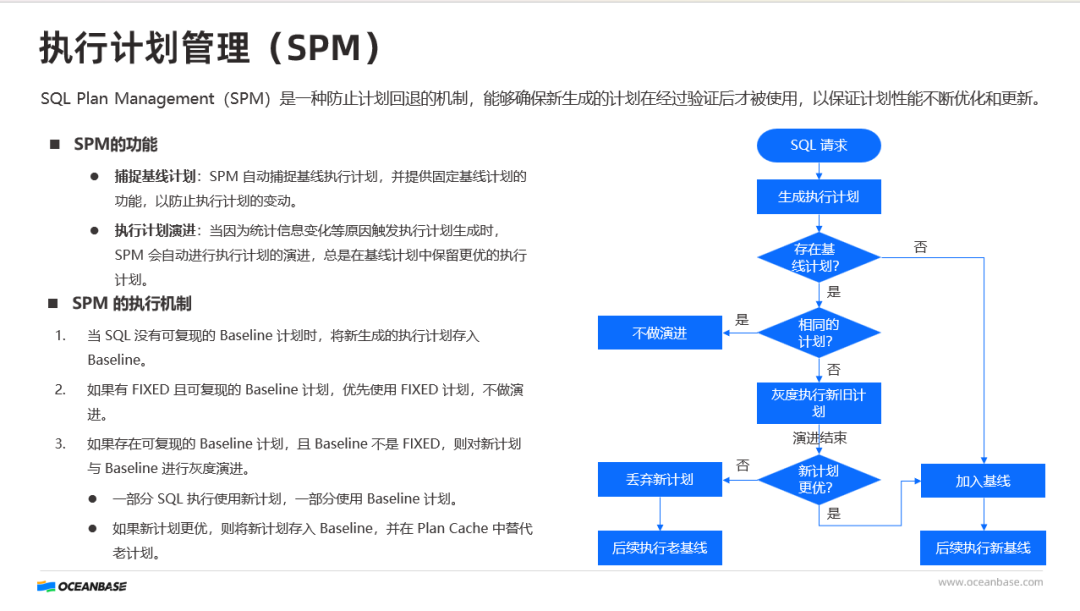
3.1.2 SPM 测试
在做 SPM 测试之前,再次清理之前的索引和 BASELINE (如果有的话)。
1 2 3 4 5
obclient -h192.0.2.11 -uroot@test#obcluster -P2883 -p<YOUR_PASSWORD> -c -A test alter table sbtest1 drop index ix1; alter system flush plan cache global; select DBMS_SPM.DROP_SQL_PLAN_BASELINE('test','9D827857E23201D96198DB6944874F35','16326534133740390936'); select DBMS_SPM.DROP_SQL_PLAN_BASELINE('test','9D827857E23201D96198DB6944874F35','1645389932264426918');
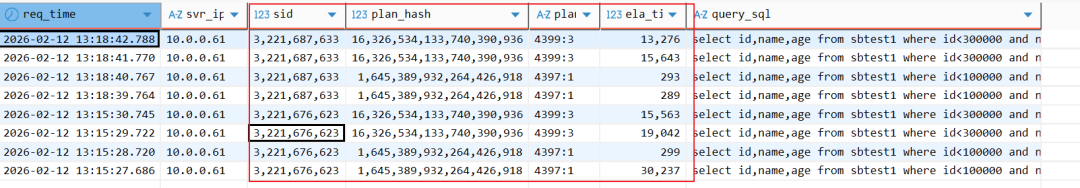
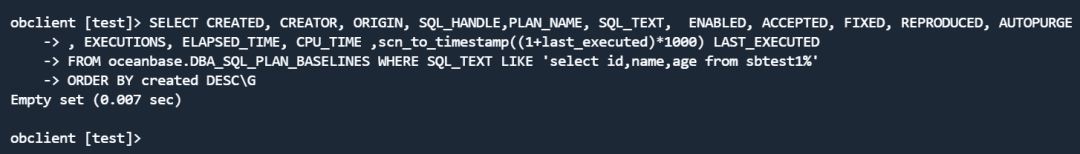
不开 BASELINE,跑下面测试 SQL。
1 2 3 4 5 6 7 8 9 10 11 12
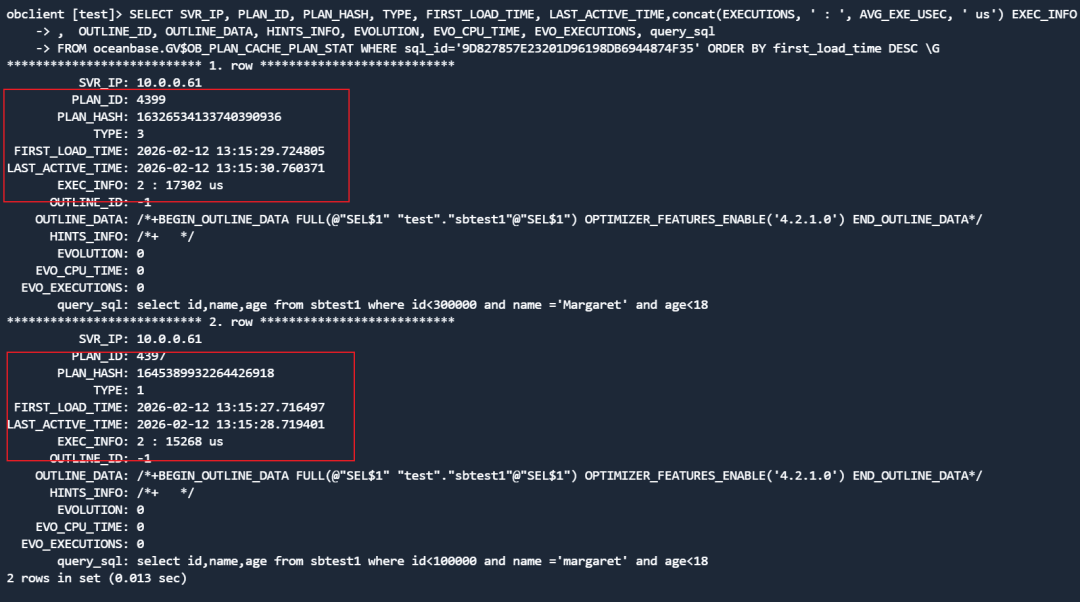
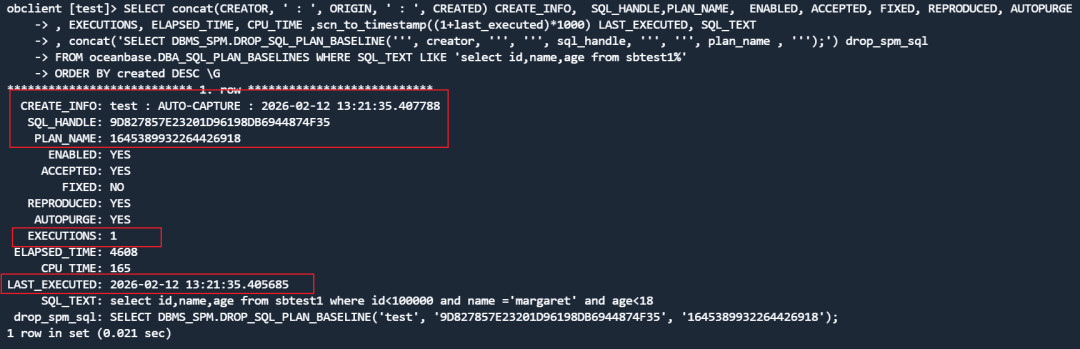
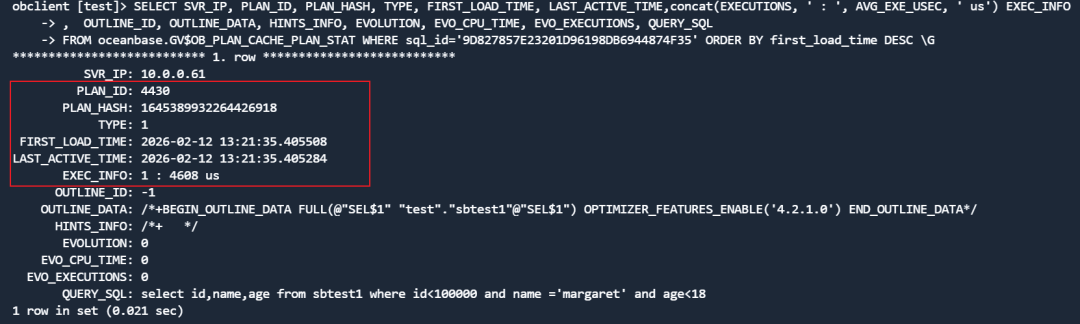
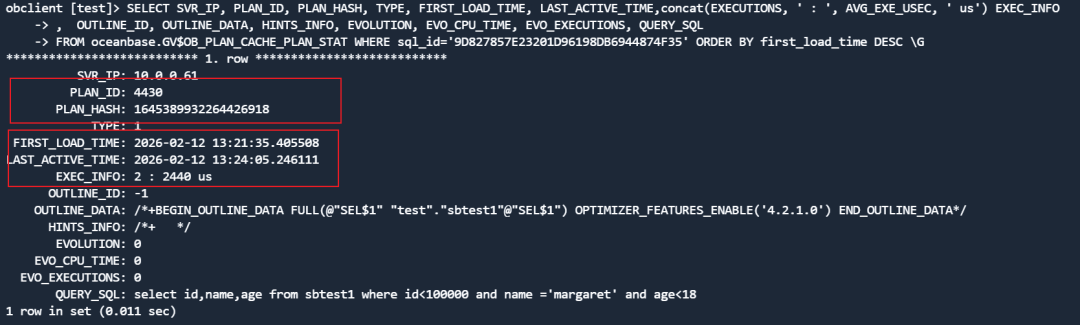
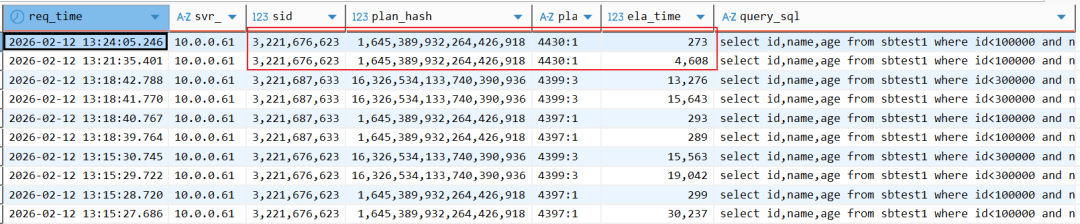
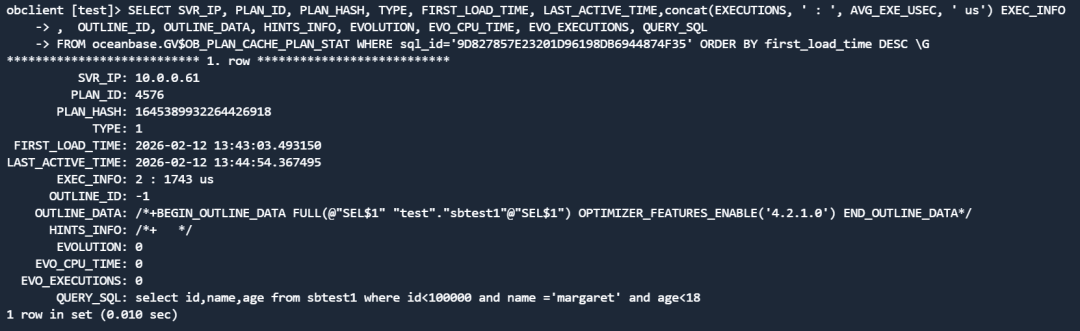
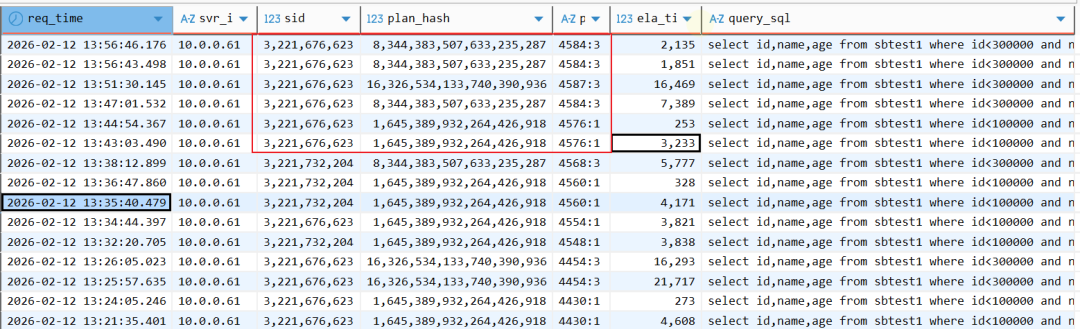
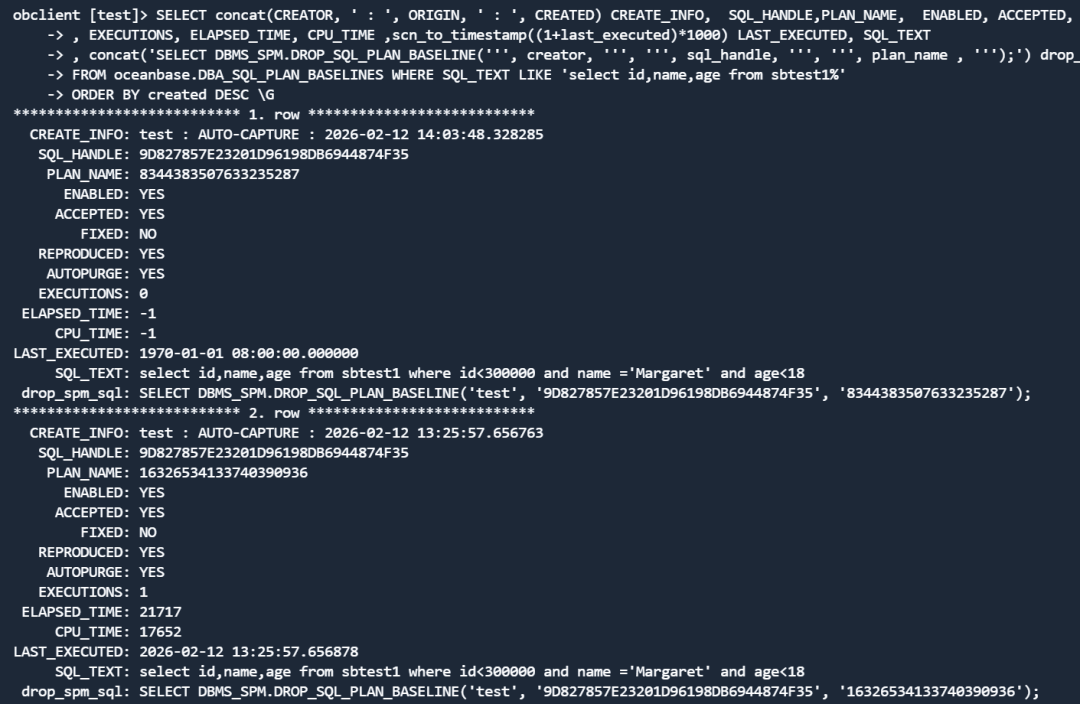
show variables like'%baseline%'; select id,name,age from sbtest1 where id<100000and name ='margaret'and age<18; select sleep(1); select id,name,age from sbtest1 where id<100000and name ='margaret'and age<18; select sleep(1); select id,name,age from sbtest1 where id<300000and name ='Margaret'and age<18; select sleep(1); select id,name,age from sbtest1 where id<300000and name ='Margaret'and age<18; select sleep(1); SELECT usec_to_time(request_time) req_time, svr_ip,sid, plan_hash, concat( plan_id, ':', plan_type) plan_id, elapsed_time ela_time, query_sql FROM oceanbase.GV$OB_SQL_AUDITWHERE request_type IN (1, 2, 3) AND sql_id='9D827857E23201D96198DB6944874F35'AND db_name ='test'AND request_time >= time_to_usec('2026-2-12 13:15:00')ORDERBY request_time DESC ; SELECT CREATED, CREATOR, ORIGIN, SQL_HANDLE,PLAN_NAME, SQL_TEXT, ENABLED, ACCEPTED, FIXED, REPRODUCED, AUTOPURGE, EXECUTIONS, ELAPSED_TIME, CPU_TIME ,scn_to_timestamp((1+last_executed)*1000) LAST_EXECUTEDFROM oceanbase.DBA_SQL_PLAN_BASELINES WHERE SQL_TEXT LIKE'select id,name,age from sbtest1%'ORDERBY created DESC\G SELECT SVR_IP, PLAN_ID, PLAN_HASH, TYPE, FIRST_LOAD_TIME, LAST_ACTIVE_TIME,concat(EXECUTIONS, ' : ', AVG_EXE_USEC, ' us') EXEC_INFO, OUTLINE_ID, OUTLINE_DATA, HINTS_INFO, EVOLUTION, EVO_CPU_TIME, EVO_EXECUTIONS, query_sql FROM oceanbase.GV$OB_PLAN_CACHE_PLAN_STAT WHERE sql_id='9D827857E23201D96198DB6944874F35'ORDERBY first_load_time DESC \G
selectid,name,age from sbtest1 whereid<100000 and name ='margaret' and age<18;selectsleep(1);
SQL 重复跑,第二次直接使用缓存的执行计划,耗时更短。
跑第二个 SQL,条件不一样,应该是分布式执行计划。
1
selectid,name,age from sbtest1 whereid<300000 and name ='Margaret' and age<18;selectsleep(1);selectid,name,age from sbtest1 whereid<300000 and name ='Margaret' and age<18;selectsleep(1);
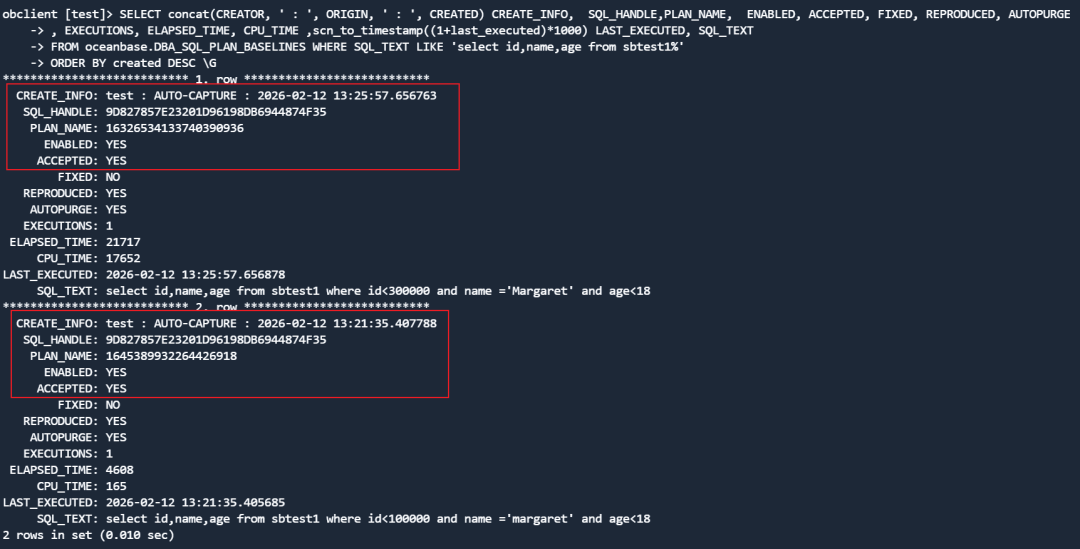
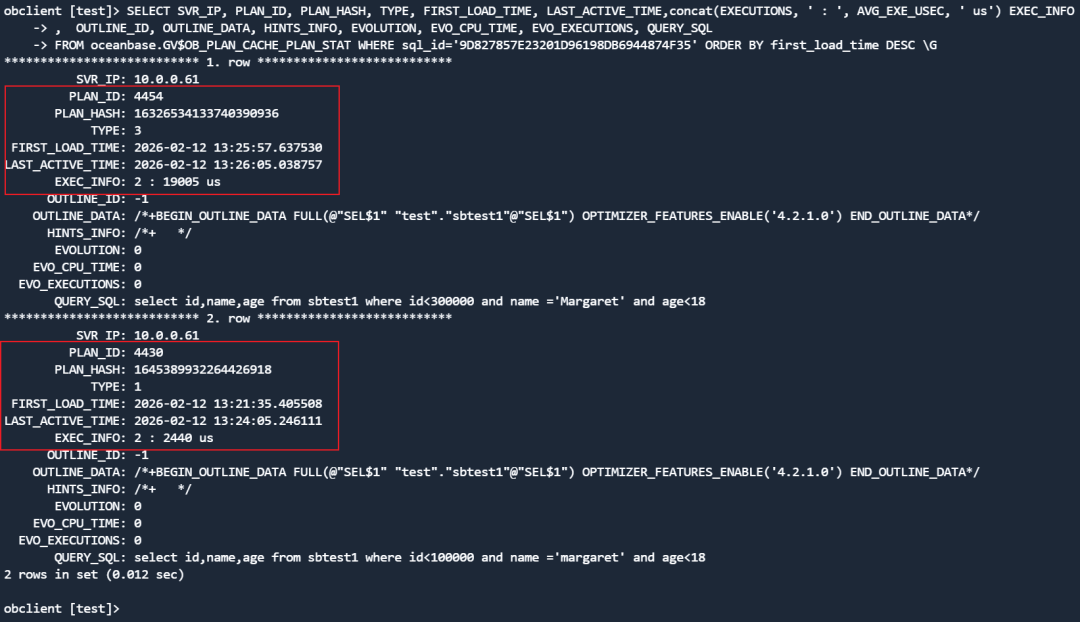
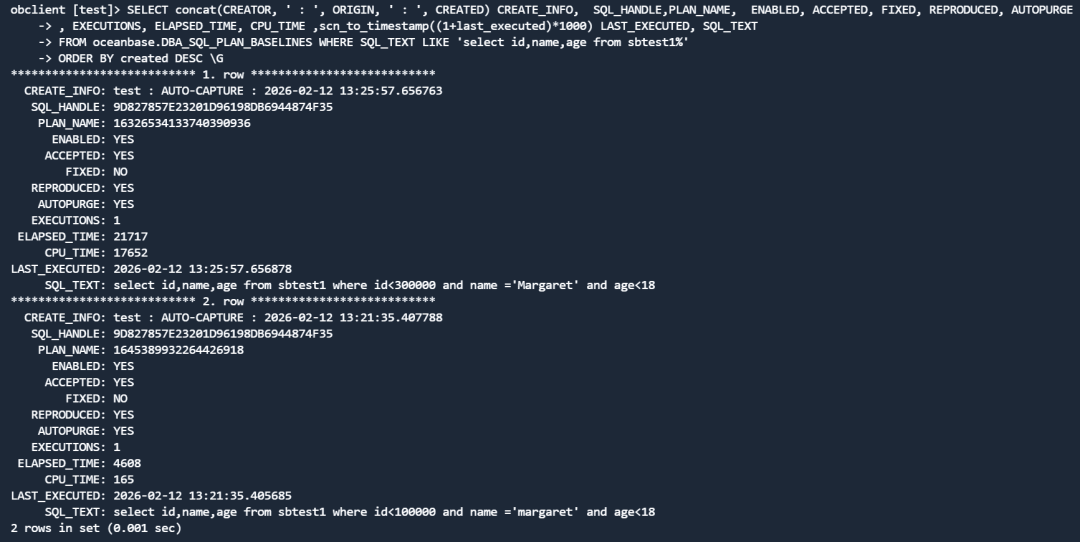
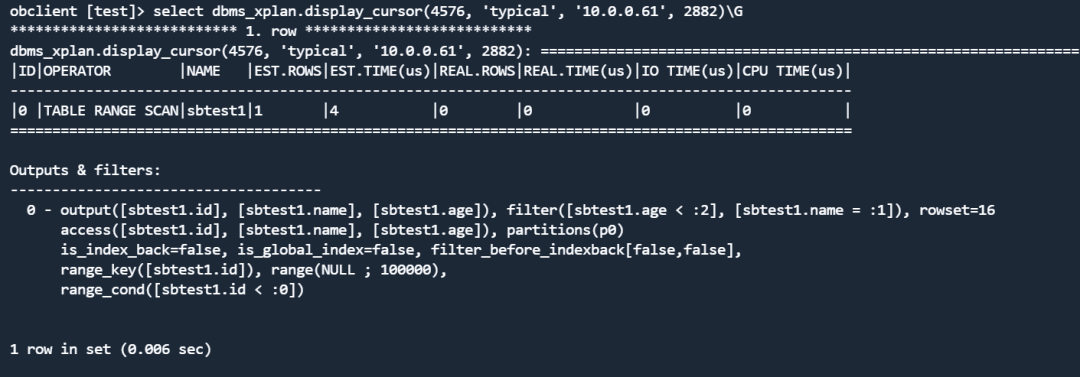
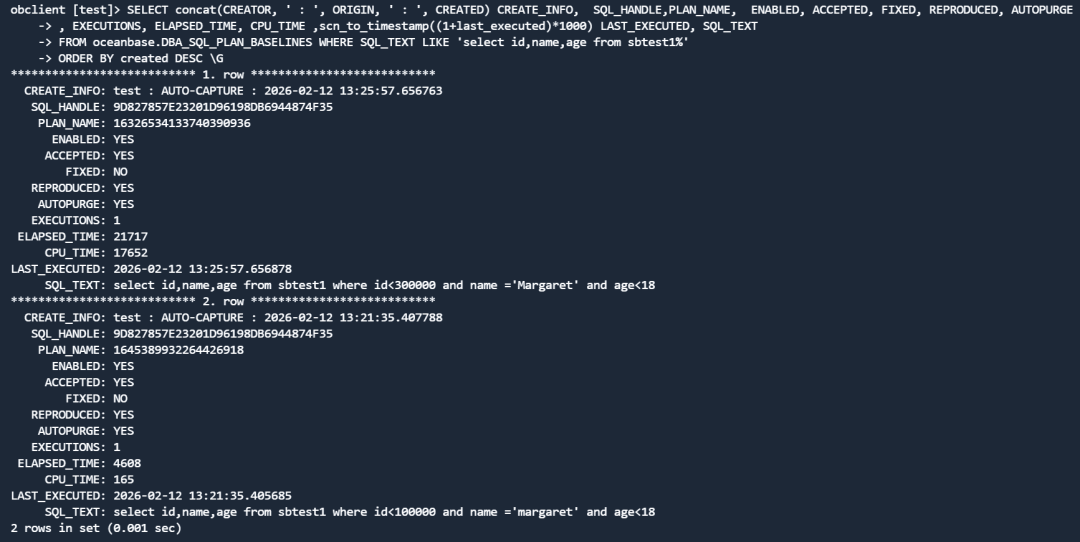
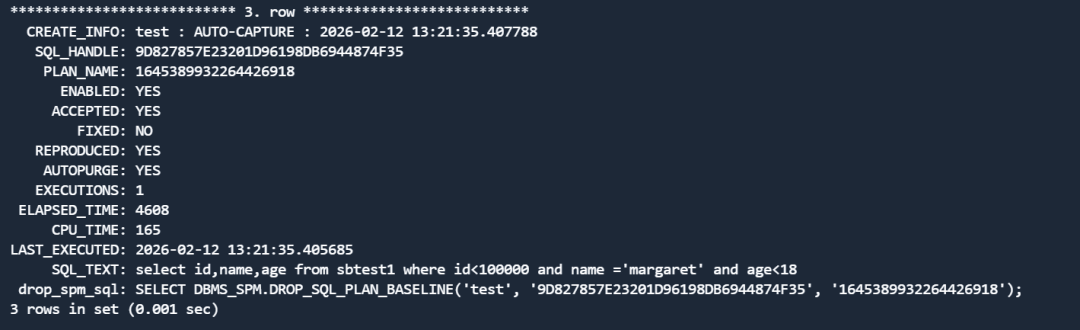
BASELINE 捕捉到新的执行计划,PLAN_NAME 936 结尾,分布式执行i计划。
此时,执行计划缓存里会有两个执行计划并存,一个本地,一个分布式。
下面开始执行计划演进测试。
回到原会话。新建索引,从而影响执行计划。
1
create index ix1 on sbtest1 (name,age) LOCAL;
重跑第一个 SQL,根据前面经验,它不会用这个索引。
1 2 3 4
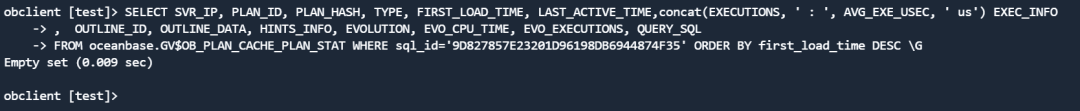
select id,name,age from sbtest1 where id<100000and name ='margaret'and age<18; select sleep(1); SELECT concat(CREATOR, ' : ', ORIGIN, ' : ', CREATED) CREATE_INFO, SQL_HANDLE,PLAN_NAME, ENABLED, ACCEPTED, FIXED, REPRODUCED, AUTOPURGE, EXECUTIONS, ELAPSED_TIME, CPU_TIME ,scn_to_timestamp((1+last_executed)*1000) LAST_EXECUTED, SQL_TEXT FROM oceanbase.DBA_SQL_PLAN_BASELINES WHERE SQL_TEXT LIKE'select id,name,age from sbtest1%'ORDERBY created DESC \G SELECT SVR_IP, PLAN_ID, PLAN_HASH, TYPE, FIRST_LOAD_TIME, LAST_ACTIVE_TIME,concat(EXECUTIONS, ' : ', AVG_EXE_USEC, ' us') EXEC_INFO, OUTLINE_ID, OUTLINE_DATA, HINTS_INFO, EVOLUTION, EVO_CPU_TIME, EVO_EXECUTIONS, QUERY_SQL FROM oceanbase.GV$OB_PLAN_CACHE_PLAN_STAT WHERE sql_id='9D827857E23201D96198DB6944874F35'ORDERBY first_load_time DESC \G
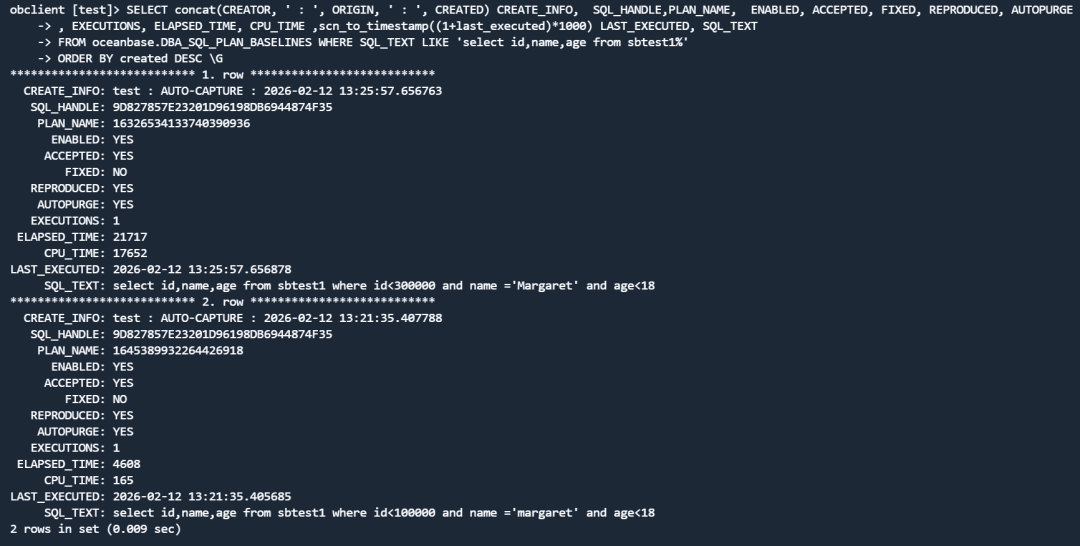
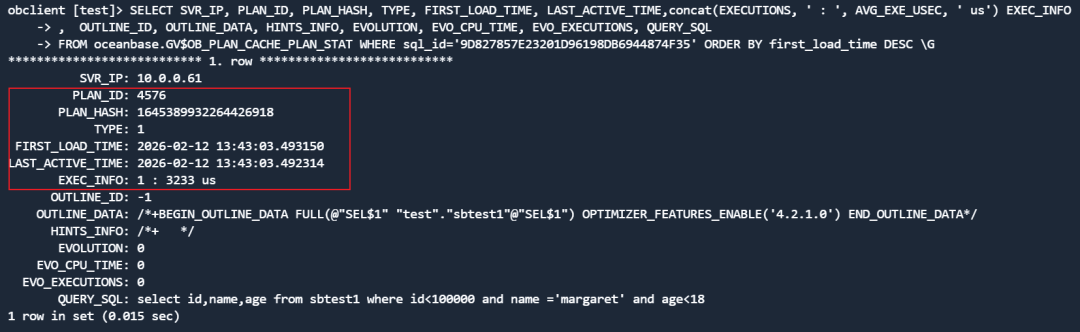
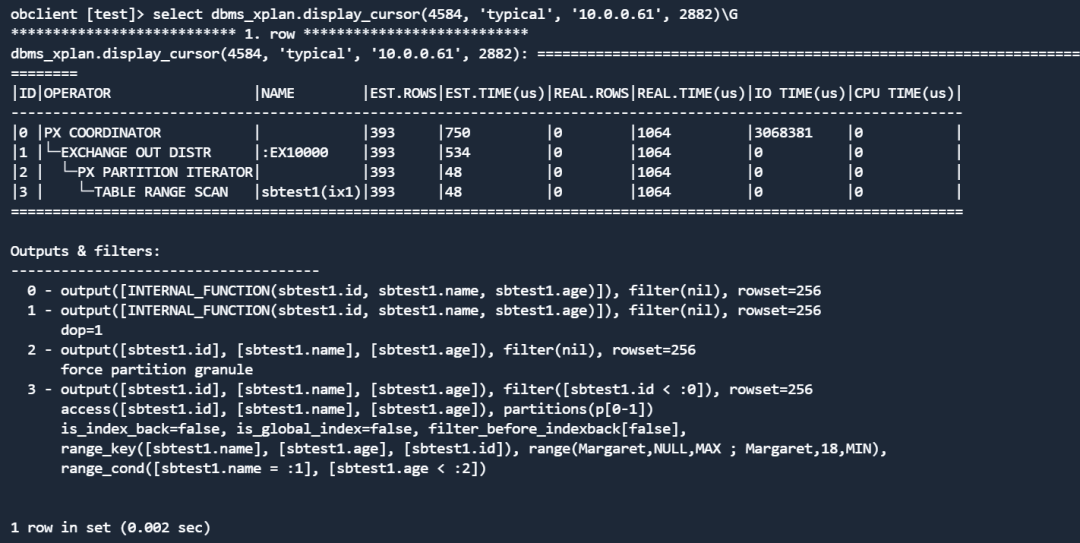
BASELINE 视图不变,执行计划缓存被清空重新生成了。
1
selectid,name,age from sbtest1 whereid<100000 and name ='margaret' and age<18;selectsleep(1);
SQL 1 执行计划没有变。
再跑第二个 SQL。
1 2 3 4
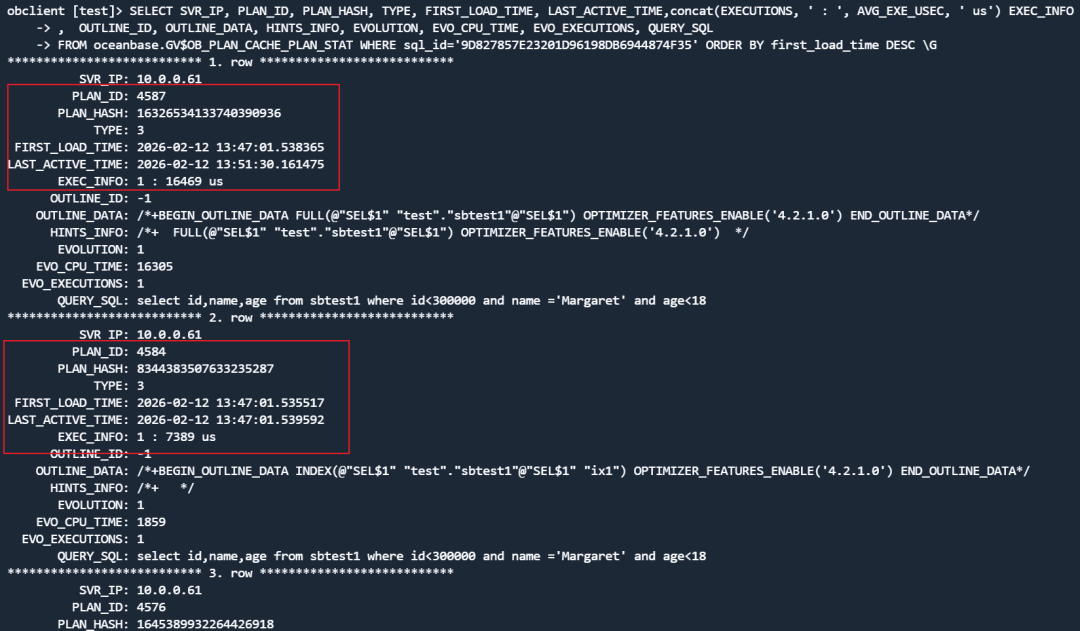
select id,name,age from sbtest1 where id<300000and name ='Margaret'and age<18; select sleep(1); SELECT concat(CREATOR, ' : ', ORIGIN, ' : ', CREATED) CREATE_INFO, SQL_HANDLE,PLAN_NAME, ENABLED, ACCEPTED, FIXED, REPRODUCED, AUTOPURGE, EXECUTIONS, ELAPSED_TIME, CPU_TIME ,scn_to_timestamp((1+last_executed)*1000) LAST_EXECUTED, SQL_TEXT FROM oceanbase.DBA_SQL_PLAN_BASELINES WHERE SQL_TEXT LIKE'select id,name,age from sbtest1%'ORDERBY created DESC \G SELECT SVR_IP, PLAN_ID, PLAN_HASH, TYPE, FIRST_LOAD_TIME, LAST_ACTIVE_TIME,concat(EXECUTIONS, ' : ', AVG_EXE_USEC, ' us') EXEC_INFO, OUTLINE_ID, OUTLINE_DATA, HINTS_INFO, EVOLUTION, EVO_CPU_TIME, EVO_EXECUTIONS, QUERY_SQL FROM oceanbase.GV$OB_PLAN_CACHE_PLAN_STAT WHERE sql_id='9D827857E23201D96198DB6944874F35'ORDERBY first_load_time DESC \G
select id,name,age from sbtest1 where id<300000and name ='Margaret'and age<18; select sleep(1); SELECT concat(CREATOR, ' : ', ORIGIN, ' : ', CREATED) CREATE_INFO, SQL_HANDLE,PLAN_NAME, ENABLED, ACCEPTED, FIXED, REPRODUCED, AUTOPURGE, EXECUTIONS, ELAPSED_TIME, CPU_TIME ,scn_to_timestamp((1+last_executed)*1000) LAST_EXECUTED, SQL_TEXT FROM oceanbase.DBA_SQL_PLAN_BASELINES WHERE SQL_TEXT LIKE'select id,name,age from sbtest1%'ORDERBY created DESC \G SELECT SVR_IP, PLAN_ID, PLAN_HASH, TYPE, FIRST_LOAD_TIME, LAST_ACTIVE_TIME,concat(EXECUTIONS, ' : ', AVG_EXE_USEC, ' us') EXEC_INFO, OUTLINE_ID, OUTLINE_DATA, HINTS_INFO, EVOLUTION, EVO_CPU_TIME, EVO_EXECUTIONS, QUERY_SQL FROM oceanbase.GV$OB_PLAN_CACHE_PLAN_STAT WHERE sql_id='9D827857E23201D96198DB6944874F35'ORDERBY first_load_time DESC \G
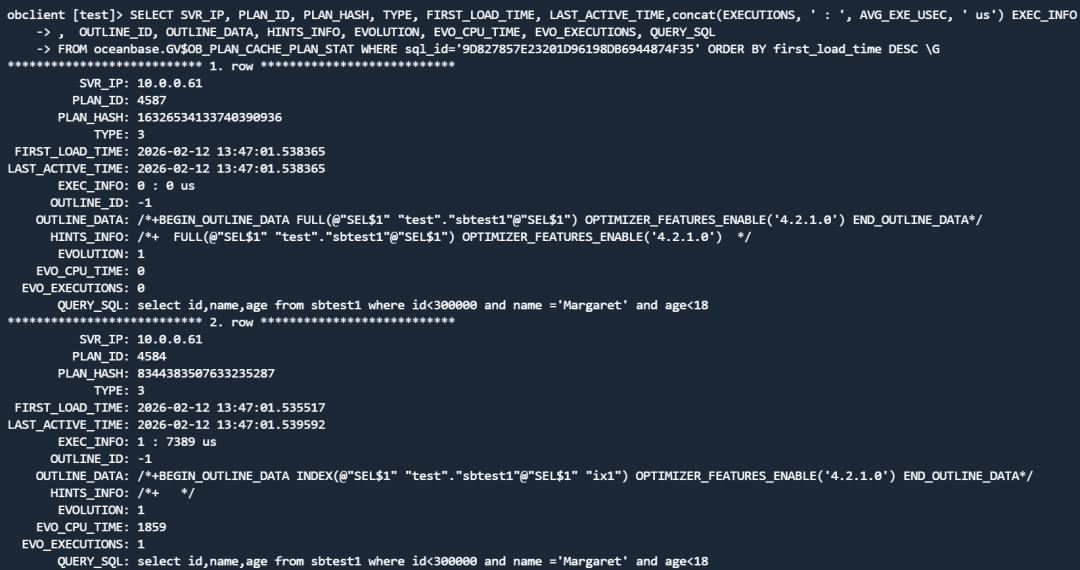
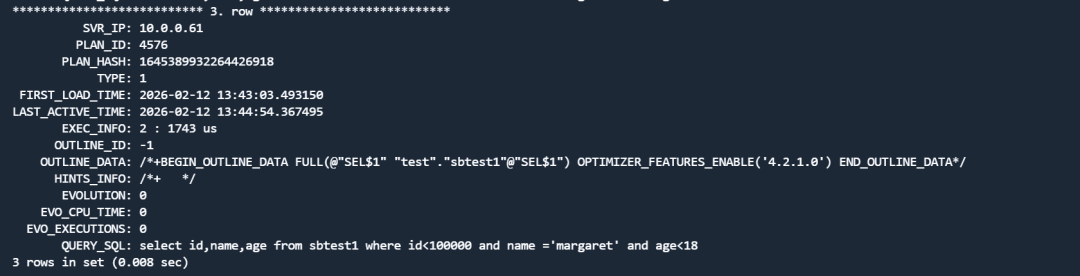
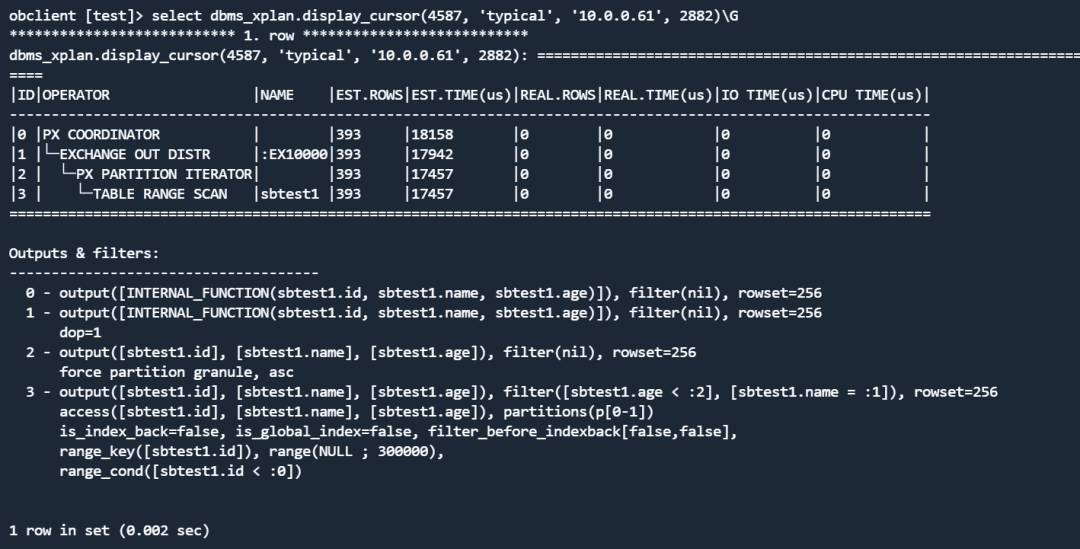
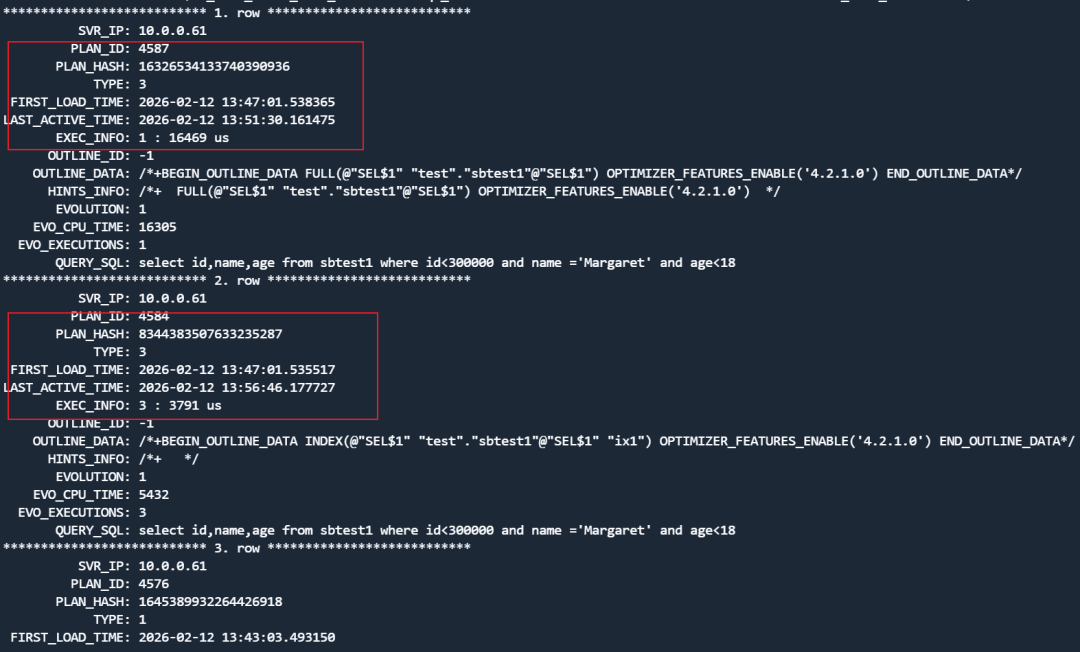
看 LAST_ACTIVE_TIME, 知这次 SQL 又走了老的执行计划(计划 1 )。
再多跑几次 SQL 2 。
1
selectid,name,age from sbtest1 whereid<300000 and name ='Margaret' and age<18;selectsleep(1);selectid,name,age from sbtest1 whereid<300000 and name ='Margaret' and age<18;selectsleep(1);

 添加社区小助手,加入微信交流群~