OceanBase obdumper 原理研究和问题处理经验
庆涛 2026年10月14日 07:30
这篇 obdumper 原理与排障实践的文章中,庆涛大佬通过 obdumper 实际发出的 SQL,梳理了数据分片、并发取数和文件生成的过程,也记录了生产中遇到的导出问题。
为大家提供了一种研究 obdumper 功能原理的思路,用于排查 obdumper 导出性能等问题。
什么是 obdumper / obloader?
obdumper(OceanBase Dumper,即 OceanBase 导出工具)是一款使用 Java 语言开发的客户端工具,目前该工具仅适用于 OceanBase 数据库。用户可以使用该工具将 OceanBase 数据库中定义的对象和表数据以指定的文件格式导出到存储介质中。如果用户希望借助于 obdumper 进行逻辑备份,可以直接将该工具集成到数据库运维系统中。
obloader(OceanBase Loader,即 OceanBase 导入工具)也是一款使用 Java 语言开发的客户端工具,目前该工具仅适用于 OceanBase 数据库。用户可以将存储介质中的数据库对象的定义文件和表数据文件导入到 OceanBase 数据库中。
通常推荐 obloader 与 obdumper 搭配使用。如果用户希望借助于 obloader 完成数据迁移工作,它也兼容 mysqldump,Mydumper 等客户端工具导出的 CSV 格式的文件。
obdumper 工作原理探究
obdumper在 OB 的数据导出和备份场景重要性非常高,问题也千奇百怪。本文提供一种根本的研究 obdumper 功能原理的思路,用于排查 obdumper 导出性能问题。
首先官网针对 obdumper 导出原理有个简单的说明。obdumper 在导出表数据时会执行以下几个步骤:
- 查询源表的元数据,包含表名、列、主键(唯一键)、分区等信息。
- 根据分区、主键等信息将表数据切分为多个分片。
- 并发导出数据并生成文件。
我们就研究这三个步骤的原理,采取的方法是观察 obdumper 任务发出的 SQL 。
obdumper 导出命令先采取最简单的,只导出一个普通表。表结构如下:
1 | CREATE TABLE t_clob_demo ( |
导出命令如下:
1 | mkdir -p /tmp/ob_oracle_export && /bin/rm -rf /tmp/ob_oracle_export |
obdumper 任务执行日志目录里会有个 sql-monitor.log 记录发出的 SQL,但是这个不包含正在执行和执行失败的 SQL。租户视图 gv$ob_processlist 观察 obdumper 正在执行的 SQL,视图gv$ob_sql_audit 观察执行过的 SQL。一般分析性能问题就看这两个视图。
查看任务导出日志目录的 sql-monitor.log
1 | 2026-09-12 10:29:36 [INFO] ==> Executing Query SQL: SELECT USERNAME FROM ALL_USERS |
这是执行完整的日志。前面一部分是取元数据信息,略过不提。就看后面三个 有 FETCH 字眼的 SQL。
1 | /* obld: Version: 4.3.6 */ SELECT"ID", ROWNUM RN FROM"TPCC"."T_CLOB_DEMO"ORDERBY"ID"OFFSET999999ROWSFETCHNEXT |
这个 SQL 作用是根据主键排序,把表数据量按固定大小(1000000 笔)切片,找到每个片段的边界值(主键值)。obdumper 没有统计表的总的记录数,而是采取这种按固定大小往前推断主键值的方法,直到最后一个 SQL 没有返回。
但是这个日志 SQL 里的参数是 ? 看不到具体的值。因此可以通过数据库视图去看。两个视图查看 SQL:
1 | select id, host, command, state, time, total_time, info, trace_id |
第一个会话视图返回结果如下:
| id | command | state | time | info |
|---|---|---|---|---|
| 596678 | Sleep | SLEEP | 6.38272 | |
| 596677 | Sleep | SLEEP | 6.548216 | |
| 596679 | Sleep | SLEEP | 6.170379 | |
| 616434 | Sleep | SLEEP | 6.125277 | |
| 536137 | Sleep | SLEEP | 6.462618 | |
| 536142 | Execute | ACTIVE | 3.901001 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO” WHERE (“ID”)>(?) AND (“ID”)<=(?) |
| 612559 | Sleep | SLEEP | 6.518485 | |
| 582905 | Sleep | SLEEP | 6.184429 | |
| 547584 | Execute | ACTIVE | 3.901047 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO” WHERE (“ID”)<=(?) |
| 565676 | Sleep | SLEEP | 6.440317 | |
| 574279 | Sleep | SLEEP | 6.529194 | |
| 547583 | Sleep | SLEEP | 6.267326 | |
| 565677 | Sleep | SLEEP | 6.215636 | |
| 574280 | Sleep | SLEEP | 6.425218 | |
| 582903 | Sleep | SLEEP | 6.563592 | |
| 529675 | Sleep | SLEEP | 3.950409 | |
| 552768 | Sleep | SLEEP | 6.249188 | |
| 616433 | Sleep | SLEEP | 6.320143 | |
| 529674 | Sleep | SLEEP | 6.300793 | |
| 599419 | Sleep | SLEEP | 6.363618 | |
| 536138 | Sleep | SLEEP | 6.283821 | |
| 616431 | Sleep | SLEEP | 6.628285 | |
| 552769 | Execute | ACTIVE | 3.9015 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO” WHERE (“ID”)>(?) |
| 562380 | Sleep | SLEEP | 6.613243 | |
| 565675 | Sleep | SLEEP | 6.598333 | |
| 599420 | Sleep | SLEEP | 6.155977 | |
| 599418 | Sleep | SLEEP | 6.534993 | |
| 562381 | Sleep | SLEEP | 6.437631 | |
| 612560 | Sleep | SLEEP | 6.339967 | |
| 574281 | Sleep | SLEEP | 6.200008 | |
| 582904 | Sleep | SLEEP | 6.390022 | |
| 529672 | Sleep | SLEEP | 6.486814 | |
| 612561 | Sleep | SLEEP | 6.141114 | |
| 616432 | Sleep | SLEEP | 6.502935 | |
| 562382 | Sleep | SLEEP | 6.232554 |
从会话视图可以看出 obdumper 发出了 35 个连接,活跃的连接数有 3 个。其原理是 obdumper 是 JAVA 程序,连接数据库也是使用连接池技术。内部连接池应该是有个初始化大小,可能是固定的也可能是动态计算的。
通过会话状态可以过滤出正在执行的 SQL 是:
1 | /* obld: Version: 4.3.6 */ SELECT "USER_NAME","AGE","SALARY","STATUS","CREATE_TIME","UPDATE_TIME","IS_VIP","DESCRIPTION","ID" FROM "T_CLOB_DEMO" WHERE ("ID") > (?) AND ("ID") <= (?) |
这个 SQL 已经不是之前说的切片 SQL,而是后面取数的 SQL。可见切片 SQL 跑的很快就过去了。实际生产上有一种导出性能问题就是切片 SQL 跑的很慢,则会被这个会话视图捕捉到。
严谨的分析方法还是看第二个视图的查询结果。
| req_time | sid | query_sql | PARAMS_VALUE | return_rows | elapsed_time |
|---|---|---|---|---|---|
| 2026-09-12 10:34:21.101 | 547584 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO” WHERE (“ID”)<=(?) | ‘1000000’ | 1000000 | 60252955 |
| 2026-09-12 10:34:21.101 | 536142 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO” WHERE (“ID”)>(?) AND (“ID”)<=(?) | ‘1000000’,’2000020’ | 1000000 | 65063452 |
| 2026-09-12 10:34:21.101 | 552769 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO” WHERE (“ID”)>(?) | ‘2000020’ | 663000 | 46795804 |
| 2026-09-12 10:34:20.770 | 529675 | /* obld: Version: 4.3.6 */ SELECT “ID”, ROWNUM RN FROM “TPCC”.”T_CLOB_DEMO” WHERE (“ID”)>( ?) ORDER BY “ID” OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY | ‘2000020’ | 0 | 280809 |
| 2026-09-12 10:34:20.541 | 529675 | /* obld: Version: 4.3.6 */ SELECT “ID”, ROWNUM RN FROM “TPCC”.”T_CLOB_DEMO” WHERE (“ID”)>( ?) ORDER BY “ID” OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY | ‘1000000’ | 1 | 226656 |
| 2026-09-12 10:34:20.316 | 529675 | /* obld: Version: 4.3.6 */ SELECT “ID”, ROWNUM RN FROM “TPCC”.”T_CLOB_DEMO” ORDER BY “ID” OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY | 1 | 220919 | |
| 2026-09-12 10:34:18.539 | 536137 | /* obld: Version: 4.3.6 */ select 1 from “TPCC”.”T_CLOB_DEMO” where rownum=1 | 1 | 1091 |
这个表的实际记录数是 2663000 条,按每个片段大小 1000000 条计算的话,分为 3 个段,最后一段只有 663000 条记录。
1 | /* obld: Version: 4.3.6 */ SELECT "ID", ROWNUM RN FROM "TPCC"."T_CLOB_DEMO" ORDER BY "ID" OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY; |
| ID | RN |
|---|---|
| 1000000 | 1000000 |
1 | /* obld: Version: 4.3.6 */ SELECT "ID", ROWNUM RN FROM "TPCC"."T_CLOB_DEMO" WHERE ("ID")>(1000000) ORDER BY "ID" OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY |
| ID | RN |
|---|---|
| 2000020 | 1000000 |
1 | /* obld: Version: 4.3.6 */ SELECT "ID", ROWNUM RN FROM "TPCC"."T_CLOB_DEMO" WHERE ("ID")>(2000000) ORDER BY "ID" OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY |
无结果输出。
这个切片 SQL 看起来很好理解,没有什么特别的。实际生产使用情形会复杂的多。
如表没有主键,只有唯一索引。此时 obdumper 导出发出的 SQL 又会有变化。
1 | create table t_clob_demo2 as select /*+ parallel(8) */ * from t_clob_demo; |
导出命令:
1 | mkdir -p /tmp/ob_oracle_export && /bin/rm -rf /tmp/ob_oracle_export |
此时命令发出的 SQL 审计如下:
| req_time | sid | query_sql | PARAMS_VALUE | return_rows | elapsed_time |
|---|---|---|---|---|---|
| 2026-09-12 11:04:16.319 | 547787 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO2” | 2663000 | 171319603 | |
| 2026-09-12 11:04:13.713 | 599518 | /* obld: Version: 4.3.6 */ select 1 from “TPCC”.”T_CLOB_DEMO2” where rownum=1 | 1 | 12450 |
可以看出表 t_clob_demo 没有主键,有唯一索引,但是 obdumper 导出的时候并没有基于唯一索引列对表数据做切片并分片并行导出。
另外一种生产常见情形就是表的主键是多列组合。
1 | ALTER TABLE t_clob_demo2 DROP CONSTRAINT uk_t_clob_demo2_user ; |
此时表数据按主键切为3个分片,并3个并发同时导出。
| req_time | sid | query_sql | PARAMS_VALUE | return_rows | elapsed_time |
|---|---|---|---|---|---|
| 2026-09-12 11:20:06.761 | 547855 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO2” WHERE (“USER_NAME”,”ID”)<=(?,?) | ‘pqxpqa43mdx6509185’,’1125233’ | 1000000 | 69036578 |
| 2026-09-12 11:20:06.761 | 536508 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO2” WHERE (“USER_NAME”,”ID”)>(?,?) | ‘user_708550’,’708550’ | 663000 | 44434284 |
| 2026-09-12 11:20:06.761 | 536507 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”AGE”,”SALARY”,”STATUS”,”CREATE_TIME”,”UPDATE_TIME”,”IS_VIP”,”DESCRIPTION”,”ID” FROM “T_CLOB_DEMO2” WHERE (“USER_NAME”,”ID”)>(?,?) AND (“USER_NAME”,”ID”)<=(?,?) | ‘pqxpqa43mdx6509185’,’1125233’,’user_708550’,’708550’ | 1000000 | 64900159 |
| 2026-09-12 11:20:06.438 | 530959 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”ID”, ROWNUM RN FROM “TPCC”.”T_CLOB_DEMO2” WHERE (“USER_NAME”,”ID”)>( ?,?) ORDER BY “USER_NAME”,”ID” OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY | ‘user_708550’,’708550’ | 0 | 275876 |
| 2026-09-12 11:20:06.015 | 530959 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”ID”, ROWNUM RN FROM “TPCC”.”T_CLOB_DEMO2” WHERE (“USER_NAME”,”ID”)>( ?,?) ORDER BY “USER_NAME”,”ID” OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY | ‘pqxpqa43mdx6509185’,’1125233’ | 1 | 421016 |
| 2026-09-12 11:20:05.552 | 530959 | /* obld: Version: 4.3.6 */ SELECT “USER_NAME”,”ID”, ROWNUM RN FROM “TPCC”.”T_CLOB_DEMO2” ORDER BY “USER_NAME”,”ID” OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY | 1 | 456729 | |
| 2026-09-12 11:20:03.861 | 562812 | /* obld: Version: 4.3.6 */ select 1 from “TPCC”.”T_CLOB_DEMO2” where rownum=1 | 1 | 7637 |
这里取中间的切片 SQL,研究其执行计划
1 | /* obld: Version: 4.3.6 */ SELECT "USER_NAME","ID", ROWNUM RN FROM "TPCC"."T_CLOB_DEMO2" WHERE ("USER_NAME","ID")>( 'pqxpqa43mdx6509185',1125233) ORDER BY "USER_NAME","ID" OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY |
这个 SQL 特殊的地方是条件:("USER_NAME","ID")>( 'pqxpqa43mdx6509185',1125233), 它等价于:"USER_NAME" > 'pqxpqa43mdx6509185' OR ( "USER_NAME" = 'pqxpqa43mdx6509185' and "ID" > 1125233)
这个 SQL 执行计划是否能走主键?
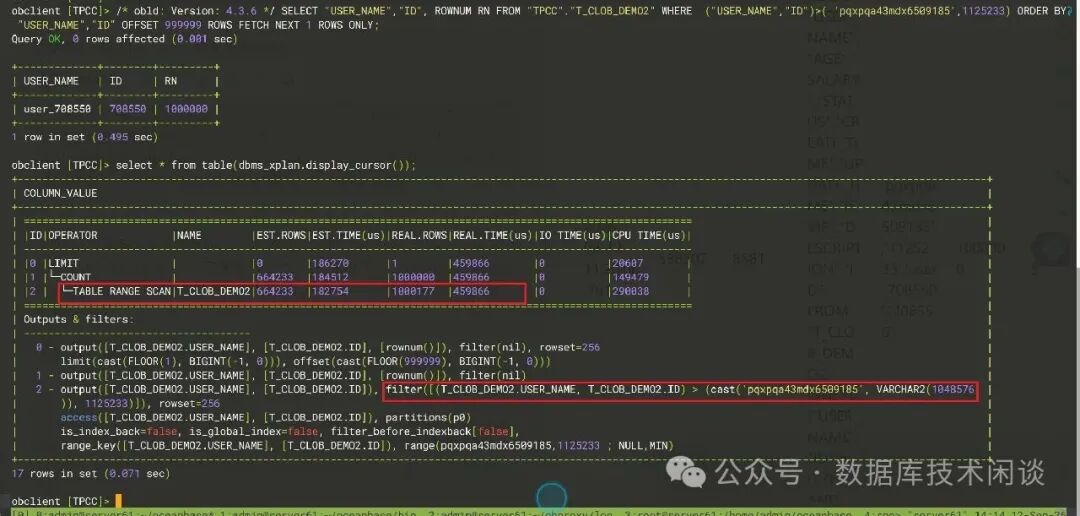
从执行计划看虽然走了主键,实际上也是扫描了 1000177 行数据,然后取了最后一行返回。在 OB 4.2.5 里,主键本身就是表,对着主键走范围扫描,跟全表扫描差不多。所以这个 SQL 从审计视图里看,执行性能也不怎么好,大概要 421 ms 左右。生产环境如果碰到过亿的大表并且主键还是组合列,这个导出性能会很差,首先就慢在切片 SQL 这里(表越大,切片数就越多,这个 SQL 执行次数就越多)。切片逻辑是串行的。
生产还有一类表是分区表。下面将表改为分区表(16个分区),看看导出逻辑是否发生变化。
1 | alter table t_clob_demo2 modify partition by hash(user_name) partitions 16; |
首先导出开始就观察到,活跃会话变为 16个,每个会话在导出一个分区。 通过 SQL 审计视图看得更全。
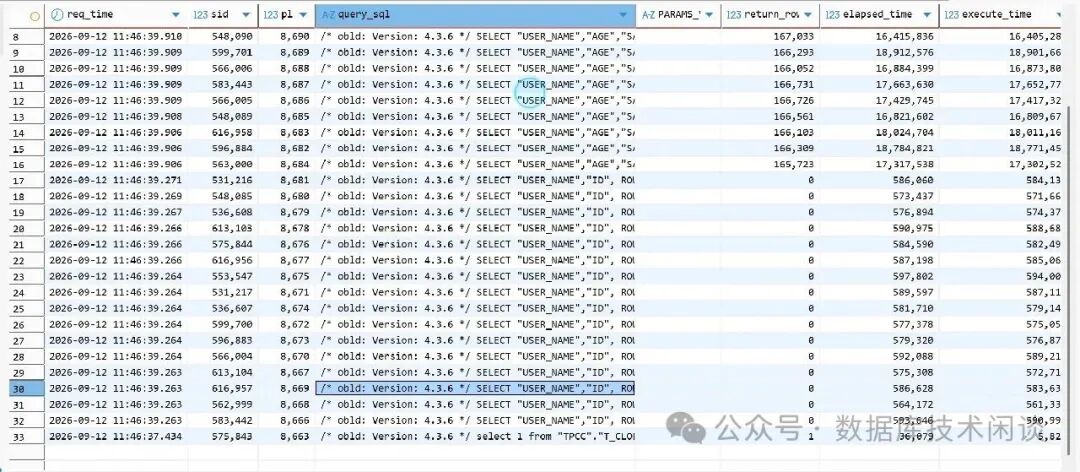
每个分区都在做切片,由于分区数据量不足 1000000,所以只有一个片段。然后每个分区直接导出所有数据。
1 | /* obld: Version: 4.3.6 */ SELECT "USER_NAME","ID", ROWNUM RN FROM "TPCC"."T_CLOB_DEMO2" PARTITION("P3") ORDER BY "USER_NAME","ID" OFFSET 999999 ROWS FETCH NEXT 1 ROWS ONLY; |
不得不说,分区表导出的性能是最快的,因为这里有 16个并发。这个 16 是 obdumper 基于多项信息综合计算出来的。生产环境导出为了规避对数据库性能影响过大,除了指定弱一致性读外,还可以手动指定并发,参数 --thread=4 。这个手动指定的并发不宜过大,超出了 obdumper 内部连接池也没有意义。关于这个并发的逻辑本文就不探索了。
按照官网文档的介绍,obdumper 在并发导出任务后,对生成文件的数量还有一套独立的逻辑。obdumper 还可以开启并行生成文件(参数:enable.parallel.write )。不开启的时候,当文件大小超出指定大小(参数 --block-size)也是会滚动生成多个文件。如果想进一步提升大表导出的性能,还可以研究一下这个文件生成的优化。
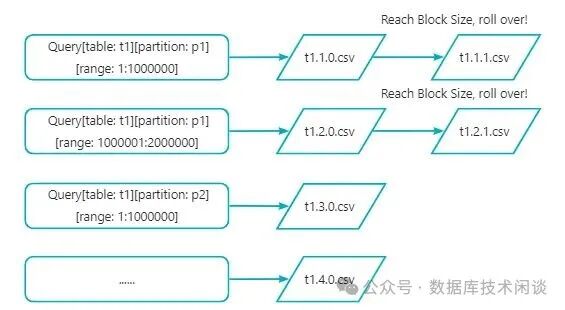
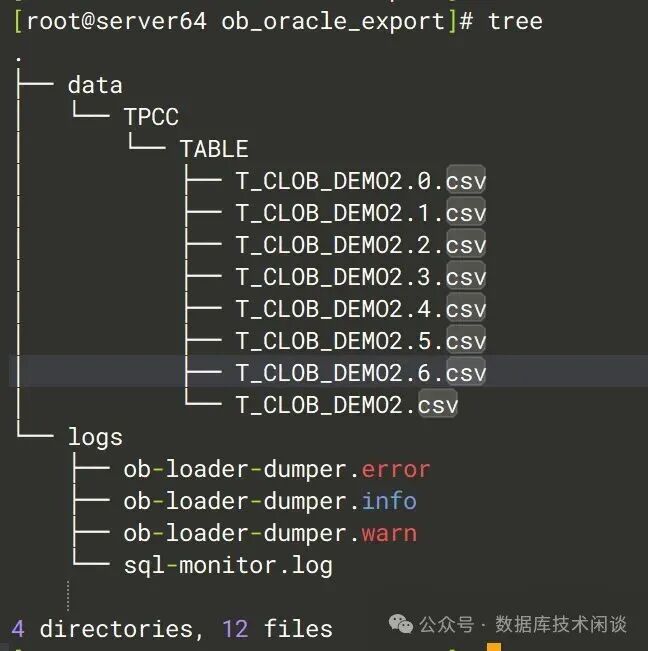
上面最后一次导出分区表,虽然有 16 个分区,实际生成文件的数量是 6个。
以上测试中,切片的大小固定都是 100万,这个是程序的默认值。这个切片大小没有办法具体指定。虽然有参数 --page-size 100000 可以指定一个取数的范围大小,从实际运行结果看,设置为小于 100万到时候,这个参数只是会影响 obdumper对切片大小的计算,但不一定会直接采纳。
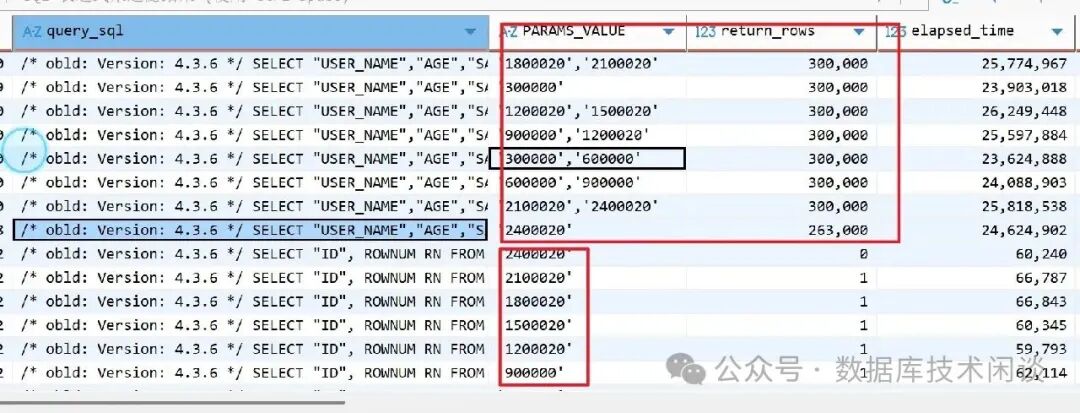
上面可以看出实际切片大小变为 30万了。如果指定 --page-size 1500000 时,实际切片大小就变为 150万。
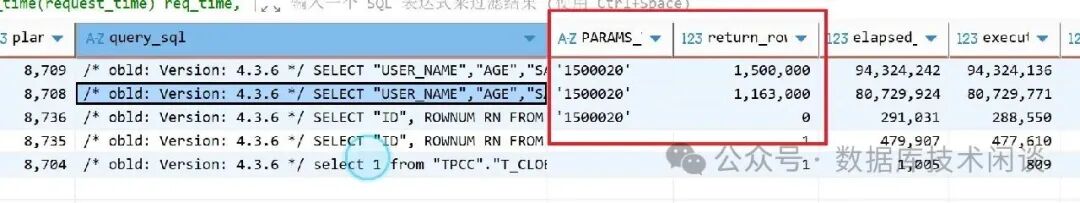
从上面截图对比可以看出,切片太大,并发的任务数可能变小,性能反而更差。到底多少合适,这个取决于很多因素,也不好统一定。切片数跟并发数参数 --thread 可能也有一定关系,但不是单方面的关系,而是跟总记录数和并发数一起有关系。具体逻辑官网文档描述的也不是很具体。
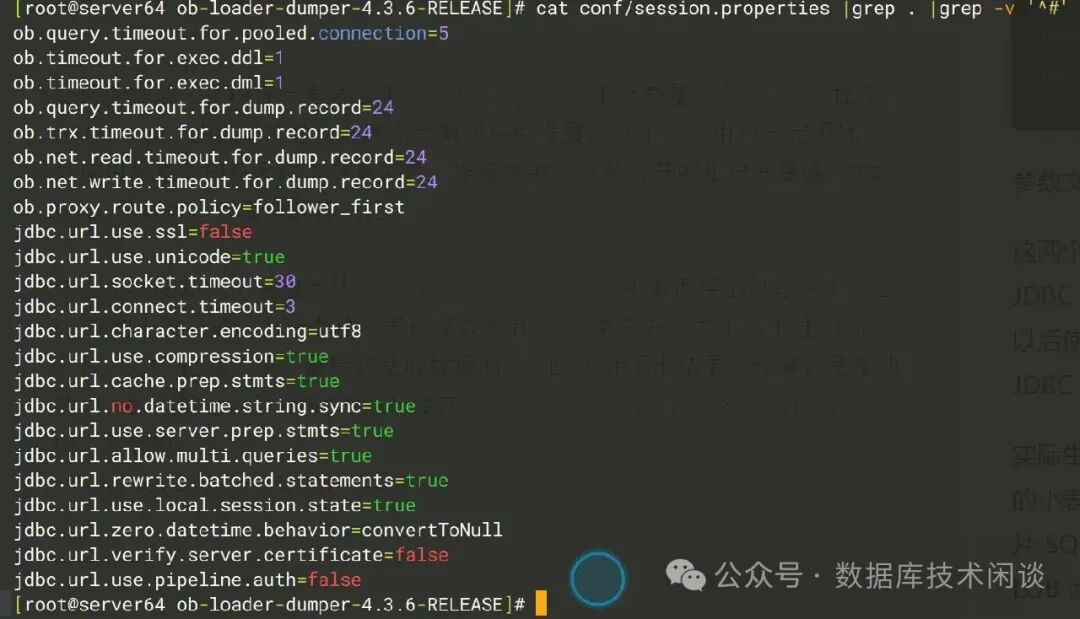
obdumper 的参数有三个地方可以调整。通常是 conf 目录下的两个配置文件(session.config.json 和 session.properties)。
参数文件 session.properties 内容如下:
参数文件 session.config.json 内容如下:
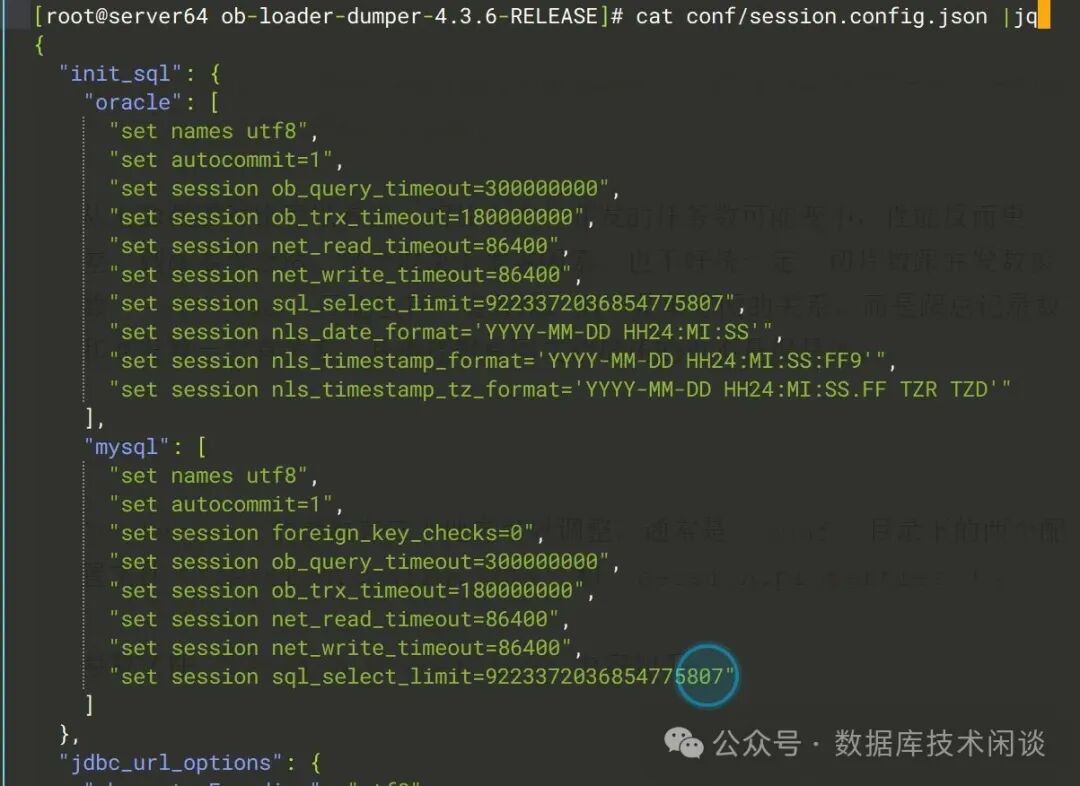
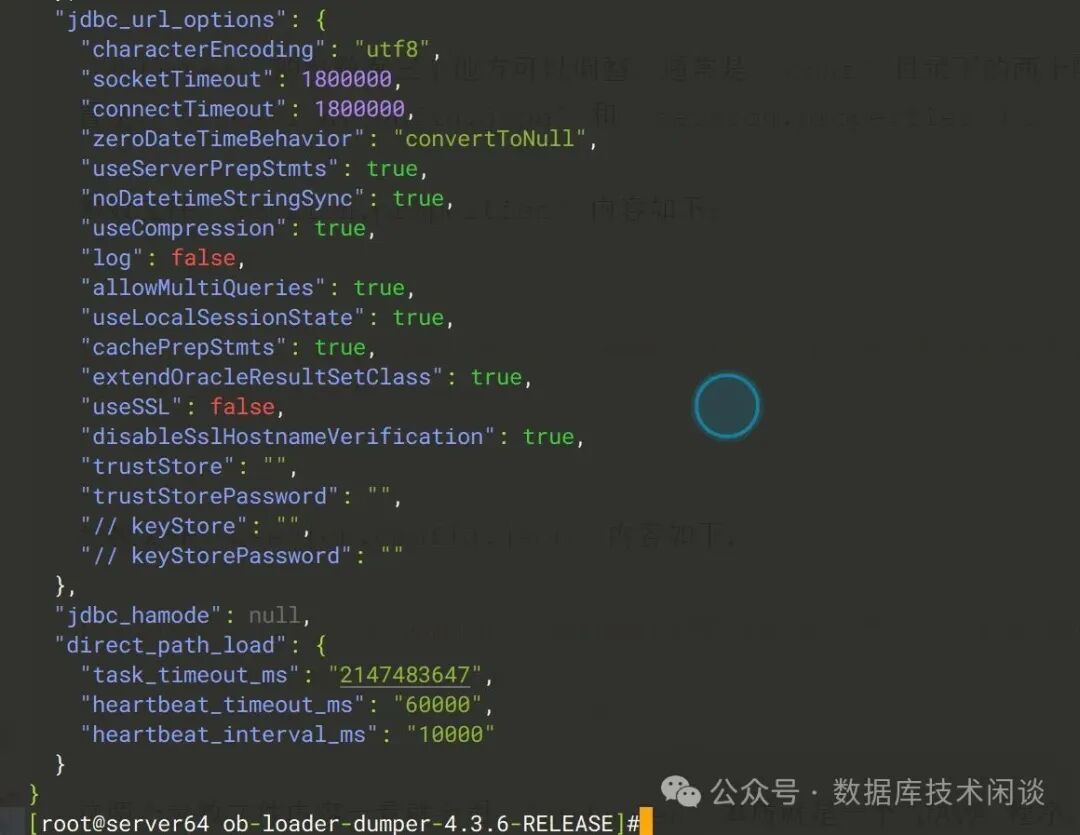
这两个参数文件内容一看就会用。obdumper 本质就是一个 JAVA 程序,JDBC URL 的选项就是在这两个参数文件中设置,这个会给用户一定困扰。以后使用更推荐用后面这个参数文件,毕竟参数名就是公开的租户变量或 JDBC URL 参数等,容易理解和记忆。
实际生产碰到一个问题就是 obdumper 4.3.5 版本再导出包含多个 CLOB 列的小表记录,出现卡住。表记录数只有 2w 条左右,大小也不过 1GB ,分片 SQL 也就一条,最后就是取数据的 SQL 卡住不出结果。经确认是驱动的 LOB 读取 BUG,解决方法只要在 session.config.json 的 JDBC URL 里增加:"UseLobLocatorV2": false 。
最后总结一下,obdumper和 obloader 目前已经成为客户生产环境非常重要的工具,有很多业务依赖 obdumper和 obloader 做业务数据的导出(备份)和导入(恢复)等。所以 obdumper 和 obloader 版本前后兼容性非常重要,其次就是性能。 obdumper 新版本可能会引入一些新功能特性,这个有可能导致以前跑的很稳定的程序出现报错或性能问题。所以,生产环境替换版本一定要做充分测试。
obdumper 本质上也是一个 JAVA 程序,逻辑简单说就是读数据库表写文件,理解其使用逻辑分为两部分;第一部分是理解数据导出的自身逻辑。主要针对 OB 的表数据导出,包括如何导出最好最快的逻辑。这些跟 OB SQL 有关。如为了导出影响最小,设置弱一致性读;为了导出最快,设置服务器端的并行(参数 --parallel);为了并行导出,如何对大表数据切片(找到边界值)等。这部分逻辑跟 obdumpe 产品自身没有关系,跟 OB 有关系。
第二部分是理解跟 obdumper JAVA 程序有关的逻辑。它是个 JAVA 程序,连接 OB 使用连接池技术,程序目的主要是导出数据写为文件,如何根据 OB 的逻辑如设置并发读取数据,以及如何将读回来的数据并发写到文件(涉及到文件重组);多个并发线程的工作量和导出的文件大小如何保持均衡等,这些是一个 JAVA 程序开发的基本功。
所以当 obdumper 使用有问题,事后反向排查的时候,就要根据报错现象、报错日志再结合数据库的 SQL 日志(OBProxy 里以及审计视图里)综合判断是哪个环节出了问题。不同客户的生产场景都不完全一样,所以obdumper面临的问题和挑战也不完全一样(也难怪 obdumper 参数选项非常多,参数文件都有两个)。
欢迎大家在评论区留言,交流您感兴趣问题。

庆涛大佬干货推荐
了解更多
 添加社区小助手,加入微信交流群~